| title |
左程云、代码随想录算法学习(二) |
| tags |
|
| categories |
|
| date |
2025-03-07 07:00:00 -0800 |
| excerpt |
C++、编程语言、算法学习 |
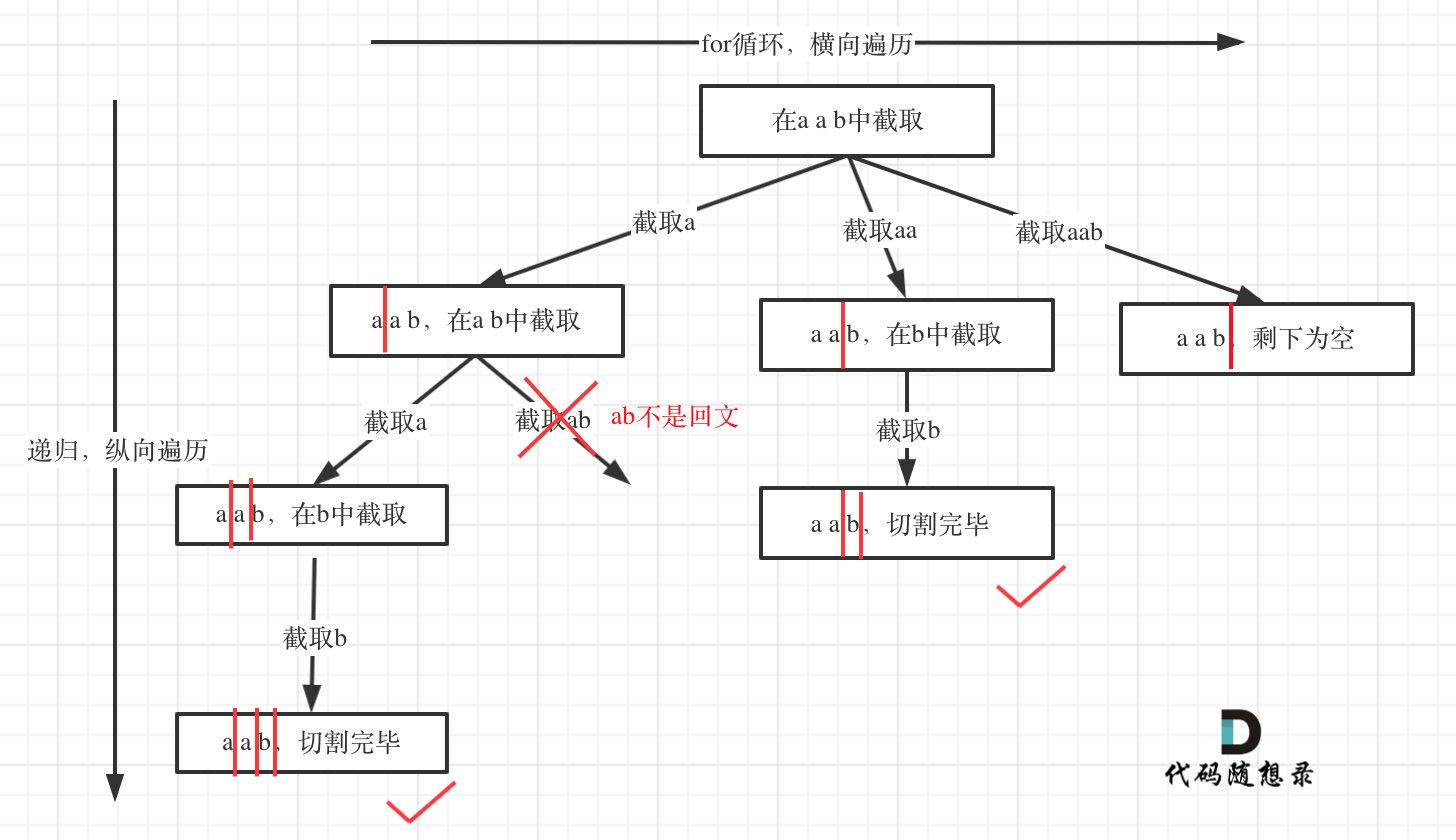
- 回溯算法的核心思想是:
- 递归构造解空间树,在树的每个节点上做出一个选择,并继续探索;若当前选择不符合条件则回退(撤销选择);
- 回溯法抽象为树形结构后,其遍历过程就是:
for 循环横向遍历,递归纵向遍历,回溯不断调整结果集。
- 代码模板:
void backtracking(参数) {
    if (终止条件) {
        存放结果;
        return;
    }
    // 递归遍历
    for (选择:本层集合中元素(树中节点孩子的数量就是集合的大小)) {
        处理节点;
        backtracking(路径,选择列表); // 递归
        回溯,撤销处理结果
    }
}
- 组合问题:77.组合
- 思路:
- 当当前路径
path 中的元素数量达到 k,即完成一个组合,加入结果集中,作为终止条件;
- 从
startpoint 开始,避免重复元素;
- 每次递归往路径中添加一个数字
i;
- 然后递归继续选下一个数(从
i+1 开始);
- 最后撤销上一步的选择,进行回溯。
- 代码:
class Solution {
public:
    vector<int> path;
    vector<vector<int>> result;
    void backtracking(int n, int k,int startpoint){
        // 终止条件
        if(path.size() == k){
            result.push_back(path);
            return;
        }
        // 递归遍历
        for(int i=startpoint; i<=n; i++){
            path.push_back(i);
            backtracking(n, k, i+1);
            path.pop_back();
        }
    }

    vector<vector<int>> combine(int n, int k) {
        backtracking(n, k, 1);
        return result;
    }
};
- 剪枝优化:
- 在递归遍历部分可以进行剪枝优化,
for 循环至多从 n-(k-path.size())+1 这个位置开始才能避免无效的递归遍历。
- 剪枝优化后代码:
class Solution {
public:
    vector<int> path;
    vector<vector<int>> result;
    void backtracking(int n, int k,int startpoint){
        // 终止条件
        if(path.size() == k){
            result.push_back(path);
            return;
        }
        // 剪枝优化 n-(k-path.size())+1
        for(int i=startpoint; i<=n-(k-path.size())+1; i++){
            path.push_back(i);
            backtracking(n, k, i+1);
            path.pop_back();
        }
    }

    vector<vector<int>> combine(int n, int k) {
        backtracking(n, k, 1);
        return result;
    }
};
- 组合总和 III:216.组合总和 III
- 思路:这道题目与上一题较为类似,仅需在遍历过程中加上求和
sum 的过程以及 sum 的回溯过程即可。同样可以做剪枝操作:
- 当总和
sum 已经大于 n 的时候已经没有意义,不再需要继续遍历;
for 循环至多从 9-(k-path.size())+1 这个位置开始才能避免无效的递归遍历。
- 代码:
class Solution {
public:
    vector<int> path;
    vector<vector<int>> result;
    int sum = 0;
    void backtracking(int k, int n, int startpoint){
        // 终止条件
        if(sum > n)
            return;
        if(path.size() == k){
            if(sum == n)
                result.push_back(path);
            return;
        }
        // 递归遍历(剪枝操作)
        for(int i = startpoint; i<=9-(k-path.size())+1; i++){
            path.push_back(i);
            sum += i;
            backtracking(k, n, i+1);
            sum -= i;
            path.pop_back();
        }
    }

    vector<vector<int>> combinationSum3(int k, int n) {
        backtracking(k, n, 1);
        return result;
    }
};
- 电话号码的字母组合:17.电话号码的字母组合
- 思路:这道题目首先需要建立数字与电话号码字母的对照数组,递归终止条件在于字符串
path 的长度和题目输入的 digits 字符串的长度相等,在递归逻辑中采用 startpoint 来控制选取 digits 字符串中的哪个数字,用 index 来表示该数字对应的手机中字符串中的字母的数量用于后续 for 循环遍历,循环内部为经典回溯算法。
- 代码:
class Solution {
public:
    vector<string> result;
    string path;
    const string Num_letterMap[10] = {
        "", // 0
        "", // 1
        "abc", // 2
        "def", // 3
        "ghi", // 4
        "jkl", // 5
        "mno", // 6
        "pqrs", // 7
        "tuv", // 8
        "wxyz", // 9
    };

    void backtracking(string digits, int startpoint){
        // 终止条件
        if(path.size() == digits.size()){
            result.push_back(path);
            return;
        }
        // 递归逻辑
        int digit = digits[startpoint]-'0'; // 取出里面的数字
        int index = Num_letterMap[digit].size();
        for(int i=0; i<index; i++){
            path.push_back(Num_letterMap[digit][i]);
            backtracking(digits, startpoint+1);
            path.pop_back();
        }
    }

    vector<string> letterCombinations(string digits) {
        if(digits.size() == 0)
            return result;
        backtracking(digits, 0);
        return result;
    }
};
- 组合总和:39.组合总和
- 思路:这道题目和之前的组合总和 III 的关键不同点在于组合总和问题能够重复利用当前元素,该条件要建立在
candidates 内的元素是不重复的,这样子遍历出来的解集也不会出现重复的组合。因此代码仅仅需要将迭代递归语句中的 i+1 改为 i 即可。
- 代码:
class Solution {
public:
    int sum = 0;
    vector<int> path;
    vector<vector<int>> result;
    void backtracking(vector<int>& candidates, int target, int startpoint){
        // 终止条件
        if(sum > target)
            return;
        if(sum == target){
            result.push_back(path);
        }
        // 遍历迭代
        for(int i=startpoint; i<candidates.size(); i++){
            sum += candidates[i];
            path.push_back(candidates[i]);
            backtracking(candidates, target, i); // 关键点
            sum -= candidates[i];
            path.pop_back();
        }
    }

    vector<vector<int>> combinationSum(vector<int>& candidates, int target) {
        backtracking(candidates, target, 0);
        return result;
    }
};
- 组合总和 II:40.组合总和 II
- 思路:这道题和之前的组合总和问题最大区别在于
candidates 数组中的元素是包含相同的重复元素,因此按照先前的遍历方式解集必定会出现重复集合,因此处理难度在于去重操作。具体操作如下:
- 先对
candidates 数组进行排序,sort(candidates.begin(), candidates.end());;
- 采用
used 数组来控制在同树层方向去重,而树枝方向不需要去重;
- 在迭代遍历逻辑中
true 表示进入下一层时相同元素可以继续用;
false 表示进入在层深度一样时相同元素不能继续用了。
- 代码:
class Solution {
public:
    vector<int> path;
    vector<vector<int>> result;
    int sum = 0;
    void backtracking(vector<int>& candidates, int target, int startpoint, vector<bool> used){
        // 终止条件
        if(sum > target)
            return;
        if(sum == target){
            result.push_back(path);
            return;
        }
        // 遍历迭代
        for(int i=startpoint; i<candidates.size(); i++){
            // used 数组控制树层去重
            if(i>0 && candidates[i] == candidates[i-1] && used[i-1] == false)
                continue;
            path.push_back(candidates[i]);
            sum += candidates[i];
            used[i] = true; // true 表示进入下一层时相同元素可以继续用
            backtracking(candidates, target, i+1, used);
            used[i] = false; // 回溯置为 false,指示同层的相同元素不能再用了
            sum -= candidates[i];
            path.pop_back();
        }
    }

    vector<vector<int>> combinationSum2(vector<int>& candidates, int target) {
        sort(candidates.begin(), candidates.end());
        // 初始化used数组,第一个参数是数组大小,第二参数是每个位置的值
        vector<bool> used(candidates.size(), false);
        backtracking(candidates, target, 0, used);
        return result;
    }
};
- 分割回文串:131.分割回文串
- 思路:
- 在递归回溯逻辑中,先判断
[startpoint, i] 区间的子串是否为回文串:
- 如果是的话就获取(
s.substr(startpoint, i-startpoint+1) )该子串,然后将其添加至 path 中。
- 如果不是的话,后续不需要在遍历,直接
continue 跳过循环。
- 根据上述循环逻辑,只要
startpoint 能够到达字符串的末尾( if(startpoint>=s.size()) )就说明找到了一种分割方案,可以将 path 添加到 result 中。
- 判断字符串是否为回文串可以采用双指针法。

class Solution {
public:
    vector<vector<string>> result;
    vector<string> path;

    // 判断是否回文串
    bool isPalindrome(const string& s, int start, int end){
        int i=start, j=end;
        while(i<=j){
            if(s[i] != s[j])
                return false;
            i++;
            j--;
        }
        return true;
    }

    void backtracking(string s, int startpoint){
        // 终止条件(startpoint能够到达字符串末尾说明一定是满足分割要求)
        if(startpoint>=s.size()){
            result.push_back(path);
            return;
        }
        // 递归回溯逻辑
        for(int i=startpoint; i<s.size(); i++){
            if(isPalindrome(s, startpoint, i)){
                // 获取[startpoint,i]在s中的子串
                string str = s.substr(startpoint, i-startpoint+1);
                path.push_back(str);
            }
            else // 不是回文串,跳过
                continue;
            backtracking(s, i+1);
            path.pop_back();
        }
    }

    vector<vector<string>> partition(string s) {
        backtracking(s, 0);
        return result;
    }
};
- 复原IP地址:93.复原IP地址
- 思路:
- 这道题同样与前一题类似是分割字符串问题,同样在递归回溯逻辑中,先判断按照
[startpoint, i] 区间分割的 IP 子串是否合法:
- 合法则给子串后面加上
'.' ,递归进入下一个子串的遍历;
- 不合法则直接
continue 跳过当前循环。
- 需要注意判断 IP 地址子串是否合法的一些特性,并构成
isVaild() 函数。
- 代码:
class Solution {
public:
    // 判断子串中的数字是否合法,区间[start, end]
    bool isVaild(string& s, int start, int end){
        int sum = 0;
        if(end-start>2)
            return false;
        for(int i=start; i<=end; i++){
            if(s[i]-'0'>9 || s[i]-'0'<0)
                return false;
            else{
                sum *= 10;
                sum += s[i]-'0';
            }
        }
        if(end-start == 0 && s[start]-'0' == 0)
            return true;
        else if(end-start > 0 && s[start]-'0' == 0)
            return false;
        else if(sum > 0 && sum <= 255)
            return true;
        else
            return false;
    }

    vector<string> result;

    void backtracking(string& s, int startpoint, int pointSum){
        // 终止条件
        if(pointSum == 3){ // 已经插入了 3 个点
            // 判断从 startpoint 到末尾的子串是否合法
            if(isVaild(s, startpoint, s.size()-1)){
                result.push_back(s);
            }
            return;
        }
        // 递归回溯逻辑
        for(int i=startpoint; i<s.size(); i++){
            if(isVaild(s, startpoint, i)){
                s.insert(s.begin()+i+1, '.');
                pointSum++;
                // i+2 跳过刚加上去的 .
                backtracking(s, i+2, pointSum);
                pointSum--;
                s.erase(s.begin()+i+1);
            }
            else
                continue;
        }
    }

    vector<string> restoreIpAddresses(string s) {
        if(s.size() < 4 || s.size() > 12)
            return result; // 算是剪枝了
        backtracking(s, 0, 0);
        return result;
    }
};
- 子集:78.子集
- 思路:如果把子集问题、组合问题、分割问题都抽象为一棵树的话,那么组合问题和分割问题都是收集树的叶子节点,而子集问题是找树的所有节点!
- 因此将收获结果的代码放在了终止条件之前,确保将每个节点的结果都收集。
- 代码:
class Solution {
public:
    vector<int> path;
    vector<vector<int>> result;
    void backtracking(vector<int>& nums, int startpoint){
        // 收获结果
        result.push_back(path);
        // 终止条件
        if(startpoint >= nums.size())
            return;
        // 递归回溯逻辑
        for(int i=startpoint; i<nums.size(); i++){
            path.push_back(nums[i]);
            backtracking(nums, i+1);
            path.pop_back();
        }
    }

    vector<vector<int>> subsets(vector<int>& nums) {
        backtracking(nums, 0);
        return result;
    }
};
- 子集:90.子集 II
- 思路:这道题目与组合总和 II 比较类似,同样是采用
used 数组来控制在同树层方向去重,而树枝方向不需要去重;
- 代码:
class Solution {
public:
    vector<int> path;
    vector<vector<int>> result;
    void backtracking(vector<int>& nums, int startpoint, vector<bool>& used){
        // 收集结果
        result.push_back(path);
        // 终止条件
        if(startpoint>=nums.size())
            return;
        // 递归回溯逻辑
        for(int i=startpoint; i<nums.size(); i++){
            if(i>0 && nums[i] == nums[i-1] && used[i-1] == false)
                continue; // 树层重复元素不能使用
            else{
                path.push_back(nums[i]);
                used[i] = true; // 控制树枝重复元素可以使用
                backtracking(nums, i+1, used);
                used[i] = false;
                path.pop_back();
            }
        }
    }

    vector<vector<int>> subsetsWithDup(vector<int>& nums) {
        sort(nums.begin(), nums.end());
        vector<bool> used(nums.size(), false);
        backtracking(nums, 0, used);
        return result;
    }
};
- 非递减子序列:491.非递减子序列
- 思路:这道题目和之前需要去重的题目主要区别在于不能够对原始的
nums 数组进行排序,虽然同样是在同树层方向去重,而树枝方向不需要去重,但是不能像之前的题目一样采用 used 数组来去重了。此时需要采用 unordered_set<int> uset; 来控制每一层的去重,需要注意的是 uset 需要写在 for 循环的外面。
- 代码:
class Solution {
public:
    vector<int> path;
    vector<vector<int>> result;
    void backtracking(vector<int>& nums, int startpoint){
        // 终止条件
        if(path.size()>1)
            result.push_back(path);
        // 递归回溯
        unordered_set<int> uset; // 用于判断同树层中有没有重复的数
        for(int i=startpoint; i<nums.size(); i++){
            if(uset.find(nums[i]) != uset.end())
                continue;
            else{
                uset.insert(nums[i]);
                if(path.empty() || (!path.empty() && nums[i] >= path.back())){
                    path.push_back(nums[i]);
                    backtracking(nums, i+1);
                    path.pop_back();
                }
            }
        }
    }

    vector<vector<int>> findSubsequences(vector<int>& nums) {
        backtracking(nums, 0);
        return result;
    }
};
- 全排列:46.全排列
- 思路:普通全排列的题目是
nums 数组中没有重复的元素,因此不需要进行去重处理。全排列问题与之前的组合问题最大的区别在于 [1,2] 和 [2,1] 可以看作是两个不一样的结果,因此全排列的代码不需要 startpoint 来控制顺序,但需要 used 数组来记录哪些元素在上一个树层中已经用过了。
- 代码:
class Solution {
public:
    vector<int> path;
    vector<vector<int>> result;
    void backtracking(vector<int>& nums, vector<bool>& used) {
        // 终止条件
        if(path.size() == nums.size()){
            result.push_back(path);
            return;
        }
        // 递归回溯
        for(int i=0; i<nums.size(); i++){
            if(used[i] == true){
                path.push_back(nums[i]);
                used[i] = false;
                backtracking(nums, used);
                used[i] = true;
                path.pop_back();
            }
            else
                continue;
        }
    }

    vector<vector<int>> permute(vector<int>& nums){
        vector<bool> used(nums.size(), true);
        backtracking(nums, used);
        return result;
    }
};
- 全排列 II:47.全排列 II
- 思路:
- 这道题目相对于上一道普通全排列问题的最大区别在于
nums 数组中存在重复的元素,因此需要进行去重。去重的逻辑与组合问题的去重逻辑基本一致,就是需要先对 nums 数组进行排序,然后根据 used 数组判断是在树层中重复还是在树枝上重复,最终只需要去掉同树层中重复的情况即可。
- 同样也有不排序去重的方法,和前面的非递减子序列题目类似,采用
unordered_set<int> uset; 来控制每一层的去重,需要注意的是 uset 需要写在 for 循环的外面,但是该方法更加耗时和占用了额外的内存空间。
- 代码 1(排序去重):
class Solution {
public:
    vector<int> path;
    vector<vector<int>> result;
    void backtracking(vector<int>& nums, vector<bool>& used){
        // 终止条件
        if(path.size() == nums.size()){
            result.push_back(path);
            return;
        }
        // 递归回溯
        for(int i=0; i<nums.size(); i++){
            if(i>0 && nums[i] == nums[i-1] && used[i-1] == true)
                continue;
            if(used[i] == false) // 该元素已经被使用过了
                continue;
            else{
                path.push_back(nums[i]);
                used[i] = false;
                backtracking(nums, used);
                used[i] = true;
                path.pop_back();
            }
        }
    }

    vector<vector<int>> permuteUnique(vector<int>& nums) {
        vector<bool> used(nums.size(), true);
        sort(nums.begin(), nums.end());
        backtracking(nums, used);
        return result;
    }
};class Solution {
public:
vector<int> path;
vector<vector<int>> result;
void backtracking(vector<int>& nums, vector<bool>& used){
// 终止条件
if(path.size() == nums.size()){
result.push_back(path);
return;
}
// 递归回溯
unordered_set<int> uset; // 控制同树层间去重
for(int i=0; i<nums.size(); i++){
if(used[i] == true && uset.find(nums[i]) == uset.end()){
uset.insert(nums[i]);
path.push_back(nums[i]);
used[i] = false;
backtracking(nums, used);
used[i] = true;
path.pop_back();
}
else
continue;
}
}
vector<vector<int>> permuteUnique(vector<int>& nums) {
vector<bool> used(nums.size(), true);
backtracking(nums, used);
return result;
}
};
- N 皇后:51.N 皇后
- 思路:N 皇后问题的递归回溯函数
backtracking() 函数并不复杂,遍历行 row 中的每一列 col,并采用 isVaild() 函数判断皇后放置在坐标 [row, col] 上是否合法,合法才能继续递归。而 isVaild() 函数检查同一列或同一斜线上是否有棋子(递归算法保证了每一行是不重复的),并且需要注意的是只需要往行数减少方向检查即可,行数增大方向并没有放置皇后,因此不需要检查!
- 代码:
class Solution {
public:
    vector<vector<string>> result;
    // 检查同一列或同一斜线上是否有棋子(递归算法保证了每一行是不重复的)
    bool isVaild(vector<string>& chessboard, int x, int y, int n){
        // 检查列是否重复
        for(int i=0; i<n; i++){
            if(chessboard[i][y] == 'Q')
                return false;
        }
        // 检查45°是否重复(只需要往行数减少方向检查即可)
        for(int i=x,j=y; i>=0 && j>=0; i--,j--){
            if(chessboard[i][j] == 'Q')
                return false;
        }
        // 检查135°是否重复(只需要往行数减少方向检查即可)
        for(int i=x,j=y; i>=0 && j<n; i--,j++){
            if(chessboard[i][j] == 'Q')
                return false;
        }
        return true;
    }
    // 递归回溯函数
    void backtracking(vector<string>& chessboard, int row, int n){
        // 终止条件
        if(row == n){
            result.push_back(chessboard);
            return;
        }
        // 递归回溯(遍历行row中的每一列col)
        for(int col=0; col<n; col++){
            if(isVaild(chessboard, row, col, n)){ // 合法
                chessboard[row][col] = 'Q'; // 放置皇后
                backtracking(chessboard, row+1, n);
                chessboard[row][col] = '.'; // 回溯
            }
        }
    }

    vector<vector<string>> solveNQueens(int n) {
        vector<string> chessboard(n, string(n, '.'));
        backtracking(chessboard, 0, n);
        return result;
    }
};
- 解数独:37.解数独
- 思路:这道题目与 N 皇后问题的最大区别在于 N 皇后问题只需要遍历行
row 中的每一列 col 来寻找一个放置皇后的位置即可,而解数独这道题目需要逐个遍历各个格子,如果发现该格子为字符 '.' 则需要遍历填入字符 '1' - '9',填入一个数字后判断是否合法:
- 如果所选的数字合法则继续递归,此时如果后续递归是
true 的话就可以直接返回 true。
- 如果所选的数字不合法则在
for 循环填入下一个数字尝试。
- 或者后续递归返回
false,就需要回溯,并在 for 循环填入下一个数字尝试。
- 如果该空格填入了
9 个数字都不行则返回 false。
- 最终棋盘已经填满,则遍历完棋盘都没有返回
false,说明找到了合适棋盘位置了,直接返回 true。
- 代码:
class Solution {
public:
    bool isValid(int x, int y, char k, vector<vector<char>>& board){
        int n = board.size();
        // 判断行是否有字符k
        for(int i=0; i<n; i++){
            if(board[x][i] == k)
                return false;
        }
        // 判断行是否有字符k
        for(int i=0; i<n; i++){
            if(board[i][y] == k)
                return false;
        }
        // 判断九宫格内是否有字符k
        int m = x-x%3;
        int l = y-y%3;
        for(int i=m; i<m+3; i++){
            for(int j=l; j<l+3; j++){
                if(board[i][j] == k)
                    return false;
            }
        }
        return true;
    }

    bool backtracking(vector<vector<char>>& board){
        // 不需要终止条件
        int n = board.size();
        for(int i=0; i<n; i++){
            for(int j=0; j<n; j++){
                if(board[i][j] == '.'){
                    // 依次填入'1' - '9'
                    for(char k='1'; k<='9'; k++){
                        if(isValid(i, j, k, board)){
                            board[i][j] = k;
                            if(backtracking(board))
                                return true;
                            board[i][j] = '.'; // 回溯
                        }
                    }
                    // 9个数试完了都不行返回false
                    return false;
                }
            }
        }
        return true; // 遍历完没有返回false,说明找到了合适棋盘位置了
    }

    void solveSudoku(vector<vector<char>>& board) {
        backtracking(board);
    }
};
- 贪心的本质是选择每一阶段的局部最优,从而达到全局最优。
- 贪心算法一般分为如下四步:
- 将问题分解为若干个子问题
- 找出适合的贪心策略
- 求解每一个子问题的最优解
- 将局部最优解堆叠成全局最优解
- 这个四步其实过于理论化了,我们平时在做贪心类的题目时,如果按照这四步去思考,真是有点“鸡肋”。做题的时候,只要想清楚局部最优是什么,能否推导出全局最优,其实就够了。
- 总结:贪心没有套路,说白了就是常识性推导加上举反例。
- 分发饼干:455.分发饼干
- 思路:这里的局部最优就是用尽可能接近该小孩胃口的饼干喂饱该小孩,充分利用饼干尺寸喂饱一个小孩,全局最优就是喂饱尽可能多的小孩。
- 代码开始是需要对两个数组进行排序,排序后判断胃口最小的小孩都比最大的饼干大则直接返回
0。
- 采用
index 控制遍历饼干大小数组的起始位置,当饼干 [j] 已经投喂了小孩 [i] 之后,小孩 [i+1] 就需要用 [j+1] 及之后的饼干投喂了。否则容易造成超时问题。
- 代码:
class Solution {
public:
    int findContentChildren(vector<int>& g, vector<int>& s) {
        int ans = 0;
        sort(g.begin(), g.end());
        sort(s.begin(), s.end());
        // 排序后判断胃口最小的小孩都比最大的饼干大则直接返回0
        if(s.size()>0 && g[0]>s[s.size()-1])
            return 0;
        int index = 0;
        for(int i=0; i<g.size(); i++){
            for(int j=index; j<s.size(); j++){
                if(s[j] >= g[i]){
                    ans++;
                    index = j+1;
                    break;
                }
            }
        }
        return ans;
    }
};
- 摆动序列:376.摆动序列
- 思路一:默认序列至少一个元素是峰值,令
result = 1,例如只有一个元素或者所有元素全部相等的的序列 [2] 和 [2,2,2,2],元素本身就是峰值。对于序列 [1,2,2,2,3,4] ,只有出现峰值的时候才更新 pre 的值,这样就能保证当 nums[i] 指向最后一个 2 的时候出现多加 1 的情况。
- 代码:
class Solution {
public:
    int wiggleMaxLength(vector<int>& nums) {
        // 默认至少一个元素是峰值
        int result = 1;
        if(nums.size() == 1)
            return 1;
        if(nums.size() > 2){
            int pre = 0;
            int nex = 0;
            for(int i=0; i<nums.size()-1; i++){
                nex = nums[i+1] - nums[i];
                // 出现峰值
                if((pre>=0 && nex<0) || (pre<=0 && nex>0)){
                    result++;
                    pre = nex;
                }
            }
        }
        return result;
    }
};
- 思路二:分别使用
up 和 down 两个变量交替记录上升趋势和下降趋势,当 nums[i] > nums[i-1] 时,up = down + 1,当 nums[i] < nums[i-1] 时,down = up + 1 ,这样当趋势持续上升或者下降的时候只会 +1 一次而不会重复记录,最终取 up 和 down 两个变量的最大值即作为结果。
- 代码:
class Solution {
public:
    int wiggleMaxLength(vector<int>& nums) {
        int up = 1;
        int down = 1;
        int result = 1;
        if(nums.size() == 1)
            return result;
        if(nums.size() >= 2){
            for(int i=1; i<nums.size(); i++){
                if(nums[i] > nums[i-1])
                    up = down + 1;
                if(nums[i] < nums[i-1])
                    down = up + 1;
            }
        }
        result = max(up, down);
        return result;
    }
};
- 最大子数组和:53.最大子数组和
- 思路一(贪心解法):贪心解法的核心在于如果此前记录的子数组累加和为负数时,再和数组
nums 中后续的数相加会使得总的子数组和变小,因此子数组累加和为负数时应当置为 0,用后一个数为起点再次累加,每次需要将较大值通过 result = max(result, sum) 来记录。
- 代码:
class Solution {
public:
    int maxSubArray(vector<int>& nums) {
        // 贪心解法
        int sum = 0; // 子数组累加和
        int result = INT_MIN;
        for(int i=0; i<nums.size(); i++){
            sum += nums[i];
            result = max(result, sum);
            if(sum < 0) // 子数组累加和为负数
                sum = 0;
        }
        return result;
    }
};
- 思路二(前缀和解法):应当找到一个尽可能小的前缀和
MinPreSum,然后用当前的总和 sum 减去此时最小的前缀和跟目前的最大子数组和比较再取最大值:max(MaxSubSum, sum - MinPreSum)。
- 代码:
class Solution {
public:
    int maxSubArray(vector<int>& nums) {
        // 前缀和解法
        int sum = 0;
        // 最大子数组和
        int MaxSubSum = INT_MIN;
        // 最小前缀和(初始为0)
        int MinPreSum = 0;
        for(int i=0; i<nums.size(); i++){
            sum += nums[i];
            MaxSubSum = max(MaxSubSum, sum - MinPreSum);
            MinPreSum = min(sum, MinPreSum);
        }
        return MaxSubSum;
    }
};
- 买卖股票的最佳时机 II:122.买卖股票的最佳时机 II
- 思路:这道题目采用贪心算法的思路非常直观和简单,只要每一天的收益为正便进行股票的买卖从而使得总收益的最大化。局部最优是每一天的收益为正数,全局最优即为总的收益最大。
- 代码:
class Solution {
public:
    int maxProfit(vector<int>& prices) {
        if(prices.size() == 0 || prices.size() == 1)
            return 0;
        int sum = 0;
        for(int i=0; i<prices.size()-1; i++){
            if(prices[i] < prices[i+1])
                sum += prices[i+1] - prices[i];
        }
        return sum;
    }
};
- 跳跃游戏:55.跳跃游戏
- 思路:本题的巧妙之处在于不去纠结每一跳具体是跳几步,只需要计算在
i 这个节点能够跳的范围 cover,并在 cover 这个范围内去寻找更大的范围,最终判断能否找到到达最后的范围。
- 代码:
class Solution {
public:
    bool canJump(vector<int>& nums) {
        int cover = 0;
        for(int i=0; i<=cover; i++){
            cover = max(cover, i+nums[i]);
            if(cover >= nums.size()-1)
                return true;
        }
        return false;
    }
};
- 跳跃游戏 II:45.跳跃游戏 II
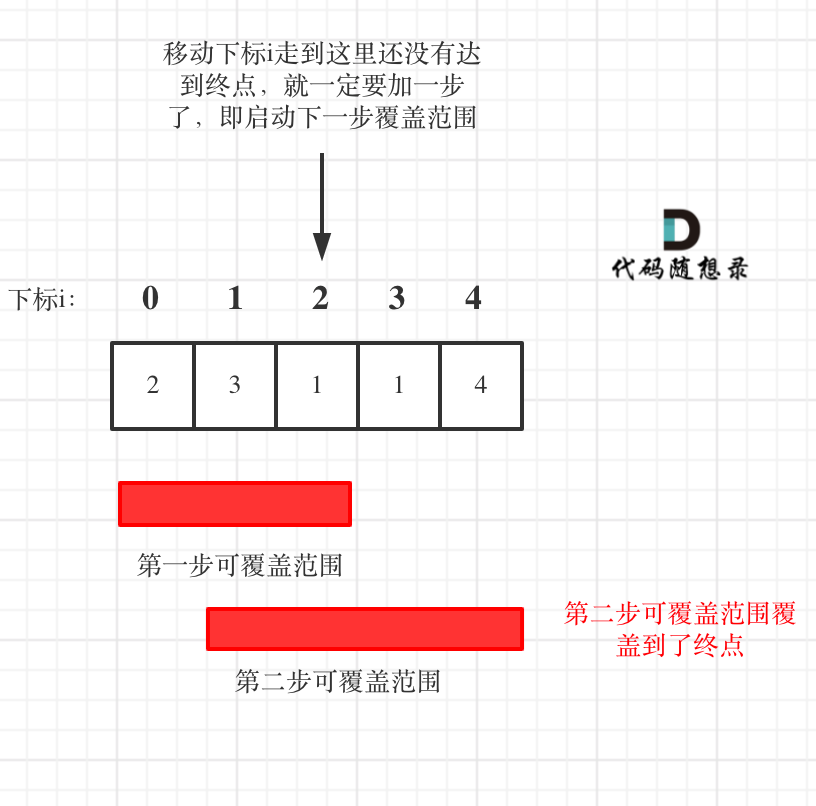
- 思路:这道题目需要求从起点跳到终点的最短跳跃次数,处理方法和上一题有较大区别。我们需要记录当前访问过的所有节点能够跳到的最远距离
max_cover,以及现阶段的覆盖距离 now_cover,要从现阶段的覆盖范围出发,不管怎么跳,覆盖范围内一定是可以跳到的,以最小的步数增加覆盖范围,覆盖范围一旦覆盖了终点,得到的就是最少步数!

class Solution {
public:
    int jump(vector<int>& nums) {
        if(nums.size() == 1)
            return 0;
        int max_cover = 0;
        int now_cover = 0;
        int ans = 0;
        for(int i=0; i<nums.size(); i++){
            max_cover = max(max_cover, i+nums[i]);
            if(i == now_cover){
                now_cover = max_cover;
                ans++;
                if(now_cover >= nums.size()-1)
                    break;
            }
        }
        return ans;
    }
};
- K 次取反后最大化的数组和:1005.K 次取反后最大化的数组和
- 思路:
- 贪心的思路:
- 当数组有正数和负数时,局部最优:让绝对值大的负数变为正数,当前数值达到最大。整体最优:整个数组和达到最大。
- 当数组只有正数和
0 后,局部最优:只让最小的数连续翻转,耗尽 K 值。整体最优:整个数组和达到最大。
- 代码:
class Solution {
public:
    int sum(vector<int>& nums){
        int ans = 0;
        for(int i=0; i<nums.size(); i++){
            ans += nums[i];
        }
        return ans;
    }

    int largestSumAfterKNegations(vector<int>& nums, int k) {
        sort(nums.begin(), nums.end());
        int i=0;
        while(i<nums.size() && nums[i]<0 && k>0){
            nums[i] = -nums[i];
            k--;
            i++;
        }
        sort(nums.begin(), nums.end());
        if(k%2 == 1) // k是奇数
            nums[0] = -nums[0];
        return sum(nums);
    }
};
- 加油站:134.加油站
- 思路:如果总油量减去总消耗大于等于零那么一定可以跑完一圈,说明各个站点的加油站剩油量相加一定是要大于等于零的。那么每个加油站的剩余量
rest[i] 为 gas[i] - cost[i] 。i 从 0 开始累加 rest[i],和记为 curSum ,一旦 curSum 小于零,说明 [0, i] 区间都不能作为起始位置,因为这个区间选择任何一个位置作为起点,到 i 这里都会断油,那么起始位置从 i+1 算起,再从 0 计算 curSum。
- 代码:
class Solution {
public:
    int canCompleteCircuit(vector<int>& gas, vector<int>& cost) {
        int curSum = 0;
        int totalSum = 0;
        int start = 0;
        for(int i=0; i<gas.size(); i++){
            curSum  = curSum + (gas[i] - cost[i]);
            totalSum  = totalSum + (gas[i] - cost[i]);
            if(curSum < 0){
                start = i+1;
                curSum = 0;
            }
        }
        if(totalSum<0)
            return -1;
        return start;
    }
};
- 分发糖果:135.分发糖果
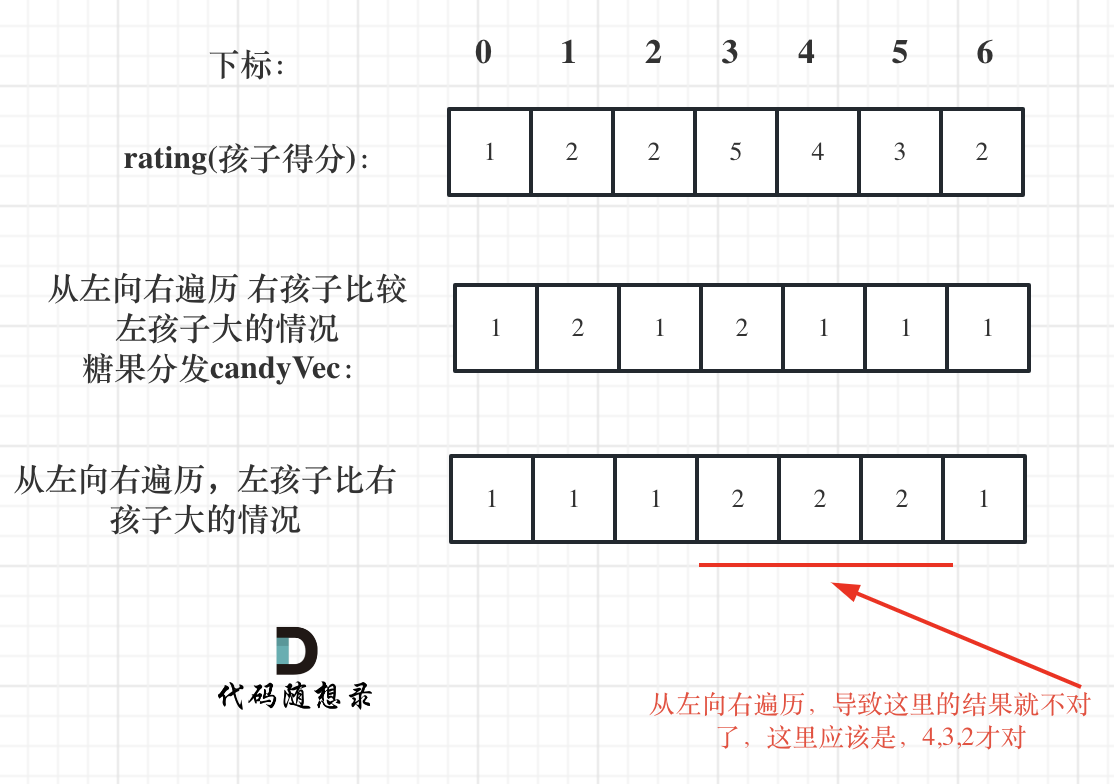
- 思路:
- 这道题需要采用两次贪心策略:
- 先确定右边评分大于左边的情况(也就是从前向后遍历)。此时局部最优:只要右边评分比左边大,右边的孩子就多一个糖果,全局最优:相邻的孩子中,评分高的右孩子获得比左边孩子更多的糖果。
- 再确定左孩子大于右孩子的情况(从后向前遍历)。局部最优:取
candy[i+1]+1 和 candy[i] 最大的糖果数量,保证第 i 个小孩的糖果数量既大于左边的也大于右边的。全局最优:相邻的孩子中,评分高的孩子获得更多的糖果。
- 在确定左孩子大于右孩子的情况,需要用上之前的右边孩子的比较情况,因此需要从后向前遍历。

class Solution {
public:
    int candy(vector<int>& ratings) {
        // 糖果数量数组,初始值为1
        vector<int> candy(ratings.size(), 1);
        // 右边孩子得分比左边孩子高(从左向右)
        for(int i=1; i<ratings.size(); i++){
            if(ratings[i]>ratings[i-1])
                candy[i] = candy[i-1]+1;
        }
        // 左边孩子得分比右边孩子高(从右向左)
        for(int i=ratings.size()-2; i>=0; i--){
            if(ratings[i]>ratings[i+1])
                candy[i] = max(candy[i], candy[i+1]+1);
        }
        int ans = 0;
        for(int i=0; i<candy.size(); i++){
            ans += candy[i];
        }
        return ans;
    }
};
- 柠檬水找零:860.柠檬水找零
- 思路:
- 有如下三种情况:
- 情况一:账单是
5,直接收下;
- 情况二:账单是
10,消耗一个 5,增加一个 10;
- 情况三:账单是
20,优先消耗一个 10 和一个 5,如果不够,再消耗三个 5 。
- 贪心策略:优先找零
10 元钞票,因为美元 10 只能给账单 20 找零,而美元 5 可以给账单 10 和账单 20 找零,美元 5 更万能!
- 代码:
class Solution {
public:
    bool lemonadeChange(vector<int>& bills) {
        int five = 0;
        int ten = 0;
        int twenty = 0;
        for(int i=0; i<bills.size(); i++){
            if(bills[i] == 5)
                five++;
            if(bills[i] == 10){
                if(five == 0)
                    return false;
                ten++;
                five--;
                twenty++;
            }
            if(bills[i] == 20){
                // 贪心策略:优先找零10元钞票
                if(ten != 0 && five !=0){
                    ten--;
                    five--;
                    twenty++;
                }
                else if(five >= 3){
                    five-=3;
                    twenty++;
                }
                else
                    return false;
            }
        }
        return true;
    }
};
- 根据身高重建队列:406.根据身高重建队列
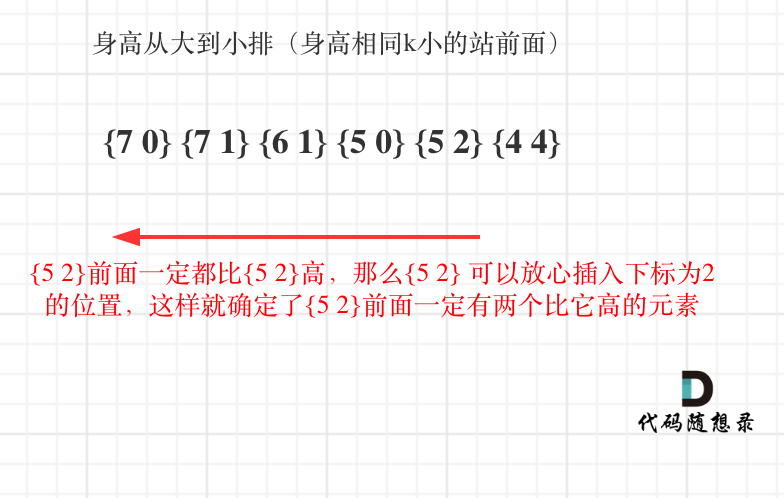
- 思路:按照身高排序之后,优先按身高高的
people 的 k 来插入,后序插入节点也不会影响前面已经插入的节点,最终按照 k 的规则完成了队列。在按照身高从大到小排序后:
- 局部最优:优先按身高高的
people 的 k 来插入。插入操作过后的 people 满足队列属性;
- 全局最优:最后都做完插入操作,整个队列满足题目队列属性。

class Solution {
public:
    static bool cmp(const vector<int>& a, const vector<int>& b){
        if(a[0] == b[0])
            return a[1]<b[1]; // 小于号从小到大排序
        return a[0]>b[0]; // 大于号从大到小排序
    }

    vector<vector<int>> reconstructQueue(vector<vector<int>>& people) {
        sort(people.begin(), people.end(), cmp);
        vector<vector<int>> result;
        int pos = 0;
        for(int i=0; i<people.size(); i++){
            pos = people[i][1];
            result.insert(result.begin()+pos, people[i]);
        }
        return result;
    }
};
- 用最少数量的箭引爆气球:452.用最少数量的箭引爆气球
- 思路:
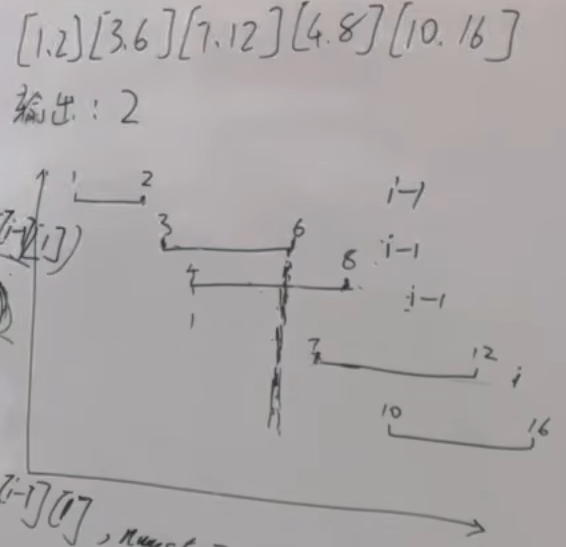
- 局部最优:当气球出现重叠,一起射,所用弓箭最少。
- 全局最优:把所有气球射爆所用弓箭最少。
- 怎么寻找重叠区域呢?首先按照各个气球的左坐标
left_idx 进行对 points 数组进行排序,遍历取当前气球的的左坐标和 left_idx 的较大值,同理,取当前气球右坐标和 right_idx 的较小值组成重叠区域。
- 初始化要射箭的总数:
ans = points.size()。
- 怎么判断是否重叠?如果
left_idx <= right_idx 说明当前气球和之前的气球重叠,需要射的箭的数量减一 ans-- ,否则不重叠并更新 left_idx 和 right_idx 的值。
- 代码:
class Solution {
public:
    static bool cmp(const vector<int>& a, const vector<int>& b){
        if(a[0] == b[0])
            return a[1] < b[1]; // 从小到大
        return a[0] < b[0]; // 从小到大
    }

    int findMinArrowShots(vector<vector<int>>& points) {
        sort(points.begin(), points.end(), cmp);
        int ans = points.size();
        int left_idx = points[0][0];
        int right_idx = points[0][1];
        if(points.size() == 1)
            return ans;
        for(int i=1; i<points.size(); i++){
            left_idx = max(left_idx, points[i][0]);
            right_idx = min(right_idx, points[i][1]);
            if(left_idx <= right_idx)
                ans--;
            else{
                left_idx = points[i][0];
                right_idx = points[i][1];
            }
        }
        return ans;
    }
};
- 无重叠区间:435.无重叠区间
- 思路:
- 关键点:判断到
intervals[i][0] < intervals[i-1][1] 说明 i 区间和 i-1 区间重叠了,在下一个循环就要判断 i+1 区间是否和 i 区间和 i-1 区间重叠的部分重叠,也就是 intervals[i][1] = min(intervals[i][1], intervals[i-1][1])。

class Solution {
public:
    static bool cmp(const vector<int>& a, const vector<int>& b){
        if(a[0] == b[0])
            return a[1] < b[1]; // 小于号表示从小到大排列
        return a[0] < b[0]; // 小于号表示从小到大排列
    }

    int eraseOverlapIntervals(vector<vector<int>>& intervals) {
        sort(intervals.begin(), intervals.end(), cmp);
        int ans = 0;
        if(intervals.size() == 1)
            return ans;
        for(int i=1; i<intervals.size(); i++){
            if(intervals[i][0] < intervals[i-1][1]){ // 重叠
                ans++;
                // 用于判断后一个区间是否和重叠区间继续重叠
                intervals[i][1] = min(intervals[i][1], intervals[i-1][1]);
            }
        }
        return ans;
    }
};
- 划分字母区间:763.划分字母区间
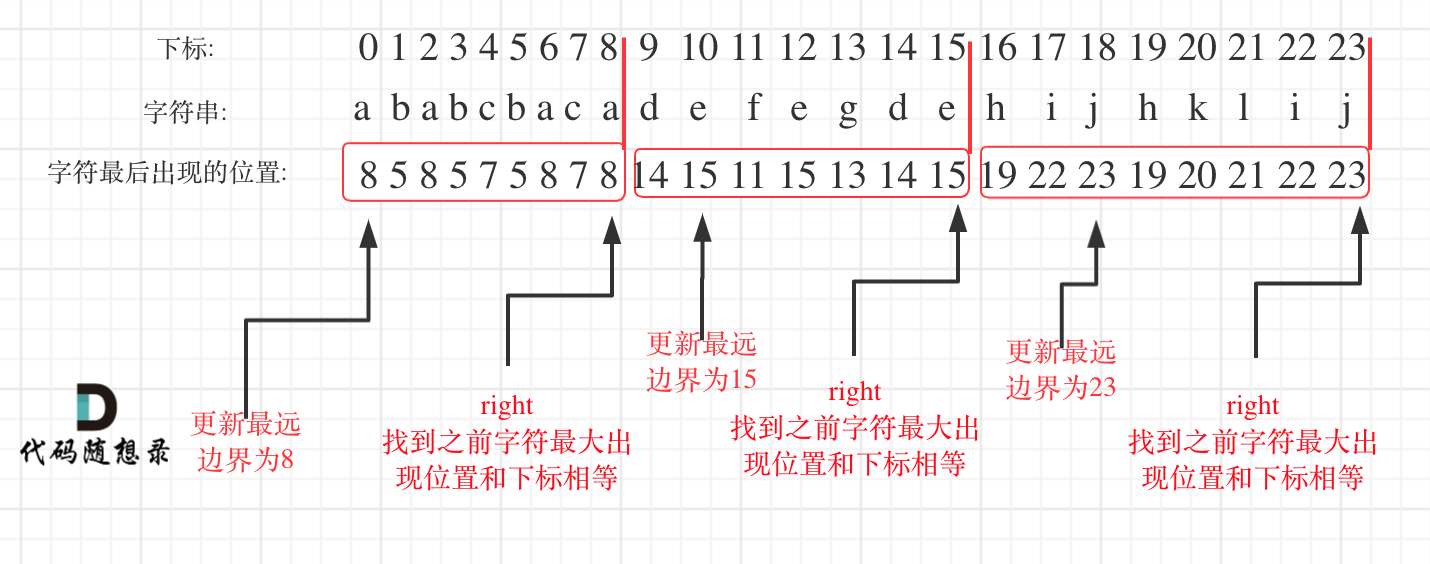
- 思路:在遍历的过程中相当于是要找每一个字母的边界,如果找到之前遍历过的所有字母的最远边界,说明这个边界就是分割点了。此时前面出现过所有字母,最远也就到这个边界了。
- 具体分为以下两步:
- 统计每一个字符最后出现的位置;
- 从头遍历字符,并更新字符的最远出现下标,如果找到字符最远出现位置下标和当前下标相等了,则找到了分割点。

class Solution {
public:
    vector<int> partitionLabels(string s) {
        vector<int> result;
        // 建立哈希数组并统计每个字母的最远出现下标
        int hash[27] = {0};
        for(int i=0; i<s.size(); i++){
            hash[s[i]-'a'] = i;
        }
        // 如果找到字符最远出现位置下标和当前下标相等了,则找到了分割点
        int left =0, right = 0;
        for(int i=0; i<s.size(); i++){
            right = max(right, hash[s[i]-'a']);
            if(i == right){
                result.push_back(right-left+1);
                left = i+1;
            }
        }
        return result;
    }
};
- 合并区间:56.合并区间
- 思路:
- 首先按照区间起点升序排列,如果起点相同,按终点升序排列。
- 从第二个区间开始,与前一个区间比较:
- 如果重叠:
intervals[i][0] <= intervals[i-1][1] → 合并为一个区间,更新当前区间的起点和终点, intervals[i] 代表合并后的区间。
- 如果不重叠:直接把前一个区间放进
result,继续循环。
- 循环结束后,把最后一个区间加入结果。
- 代码:
class Solution {
public:
    static bool cmp(const vector<int>& a, const vector<int>& b){
        if(a[0] == b[0])
            return a[1] < b[1]; // 小于号表示从小到大排序
        return a[0] < b[0]; // 小于号表示从小到大排序
    }

    vector<vector<int>> merge(vector<vector<int>>& intervals) {
        if(intervals.size() == 1)
            return intervals;
        sort(intervals.begin(), intervals.end(), cmp);
        vector<vector<int>> result;
        for(int i=1; i<intervals.size(); i++){
            // 如果重叠,合并结果放到 intervals[i] 中
            if(intervals[i][0] <= intervals[i-1][1]){
                intervals[i][0] = intervals[i-1][0];
                intervals[i][1] = max(intervals[i][1], intervals[i-1][1]);
            }
            else{
                result.push_back(intervals[i-1]);
            }
        }
        // 循环结束后,把最后一个区间加入结果
        result.push_back(intervals[intervals.size()-1]);
        return result;
    }
};
- 单调递增的数字:738.单调递增的数字
- 思路:
- 例如:
98,一旦出现 strNum[i - 1] > strNum[i] 的情况(非单调递增),首先想让 strNum[i - 1]-- ,然后 strNum[i] 给为 9,这样这个整数就是 89,即小于 98 的最大的单调递增整数;
- 从后向前遍历,就可以重复利用上次比较得出的结果了,从后向前遍历
332 的数值变化为:332 -> 329 -> 299;
flag 的作用,对于 1000 而言,只有到最后 10 才会变成 0900,不符合题意,应该将 flag 标记为 10 中 0 的位置,将后面的数都变为 9。
- 代码:
class Solution {
public:
    int monotoneIncreasingDigits(int n) {
        string s = to_string(n);
        int flag = s.size();
        for(int i=s.size()-1; i>0; i--){
            if(s[i-1] > s[i]){
                s[i-1]--;
                flag = i;
            }
        }
        for(int i=flag; i<s.size(); i++){
            s[i] = '9';
        }
        return stoi(s);
    }
};
- 监控二叉树:968.监控二叉树
- 思路:
- 为了让摄像头数量最少,我们要尽量让叶子节点的父节点安装摄像头,这样才能摄像头的数量最少。所以空节点的状态只能是有覆盖,这样就可以在叶子节点的父节点放摄像头了。
- 单层逻辑处理主要有如下四类情况:
- 情况 1:左右节点至少有一个无覆盖的情况;
- 情况 2:左右节点至少有一个有摄像头;
- 情况 3:左右节点都有覆盖;
- 情况 4:根结点没有覆盖。
- 代码:
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution {
public:
    int result = 0;
    int travelsal(TreeNode* cur){
        // 终止条件(空节点返回有覆盖的状态)
        if(cur == nullptr)
            return 2;
        // 后序遍历
        int left = travelsal(cur->left); // 左
        int right = travelsal(cur->right); // 右
        // 中
        // 左右至少一个没覆盖
        if(left == 0 || right == 0){
            result++;
            return 1;
        }
        // 左右至少有一个摄像头
        if(left == 1 || right == 1)
            return 2;
        // 左右都有覆盖
        if(left == 2 && right == 2)
            return 0;
        return -1;
    }

    int minCameraCover(TreeNode* root) {
        int state = travelsal(root);
        // 如果根节点没被覆盖,则需要加一个摄像头
        if(state == 0)
            result++;
        return result;
    }
};
- 动态规划,英文:
Dynamic Programming,简称 DP,如果某一问题有很多重叠子问题,使用动态规划是最有效的。所以动态规划中每一个状态一定是由上一个状态推导出来的,这一点就区分于贪心,贪心没有状态推导,而是从局部直接选最优的。
- 动态规划五部曲:
- 确定
dp 数组( dp table )以及下标的含义
- 确定递推公式
dp 数组如何初始化- 确定遍历顺序
- 举例推导
dp 数组
- 动规的题目,写代码之前一定要把状态转移在
dp 数组的上具体情况模拟一遍,心中有数,确定最后推出的是想要的结果。debug 的过程可以把程序中的 dp 数组打印出来与自己推导的结果进行对照来找问题。
- 斐波那契树:509.斐波那契树
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i] 的定义为:第 i 个数的斐波那契数值是 dp[i];
- 确定递推公式:状态转移方程
dp[i] = dp[i-1] + dp[i-2]; ;
dp 数组如何初始化:dp[1] = 1; 和 dp[2] = 1; ;- 确定遍历顺序:从前往后遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int fib(int n) {
        if(n == 1)
            return 1;
        if(n == 2)
            return 1;
        int dp[31];
        dp[1] = 1;
        dp[2] = 1;
        for(int i=3; i<=n; i++){
            // 递推公式
            dp[i] = dp[i-1] + dp[i-2];
        }
        return dp[n];
    }
};
- 爬楼梯:70.爬楼梯
- 思路:
- 爬到第一层楼梯有一种方法,爬到二层楼梯有两种方法。那么第一层楼梯再跨两步就到第三层,第二层楼梯再跨一步就到第三层。所以到第三层楼梯的状态可以由第二层楼梯和到第一层楼梯状态相加推导出来,那么就可以想到动态规划了。
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i] 的定义为:爬到第 i 层楼梯,有 dp[i] 种方法;
- 确定递推公式:状态转移方程
dp[i] = dp[i-1] + dp[i-2]; ;
dp 数组如何初始化:dp[1] = 1; 和 dp[2] = 2; ;- 确定遍历顺序:从前往后遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int climbStairs(int n) {
        if(n == 1)
            return 1;
        if(n == 2)
            return 2;
        int dp[46];
        dp[1] = 1;
        dp[2] = 2;
        for(int i=3; i<=n; i++){
            dp[i] = dp[i-1] + dp[i-2];
        }
        return dp[n];
    }
};
- 使用最小花费爬楼梯:746.使用最小花费爬楼梯
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i] 的定义为:爬到第 i 层楼梯的最小花费是 dp[i] ;
- 确定递推公式:状态转移方程
dp[i] = min(dp[i-1]+cost[i-1], dp[i-2]+cost[i-2]); ;
dp 数组如何初始化:dp[0] = 0; 和 dp[1] = 0; ;- 确定遍历顺序:从前往后遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int minCostClimbingStairs(vector<int>& cost) {
        // 初始化
        vector<int> dp(cost.size()+1);
        dp[0] = 0;
        dp[1] = 0;
        for(int i=2; i<dp.size(); i++){
	        // 递推公式
            dp[i] = min(dp[i-1]+cost[i-1], dp[i-2]+cost[i-2]);
        }
        return dp[dp.size()-1];
    }
};
- 不同路径:62.不同路径
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][j] 的定义为:表示从 (1,1) 出发,到 (i,j) 有 dp[i][j] 条不同的路径;
- 确定递推公式:状态转移方程
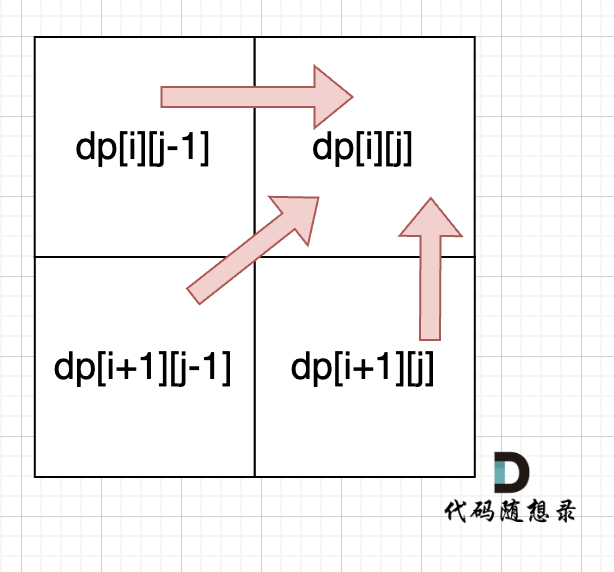
dp[i][j] = dp[i][j-1] + dp[i-1][j]; ;
dp 数组如何初始化:dp[1][1] = 1; ,其他初始化为 0;- 确定遍历顺序:从上往下、从前往后遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int uniquePaths(int m, int n) {
        vector<vector<int>> dp(m+1, vector<int>(n+1,0));
        dp[1][1] = 1;
        for(int i=1; i<=m; i++){
            for(int j=1; j<=n; j++){
                if(i!=1 || j!=1)
                    dp[i][j] = dp[i][j-1] + dp[i-1][j];
            }
        }
        return dp[m][n];
    }
};
- 不同路径 II:63.不同路径 II
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][j] 的定义为:表示从 (1,1) 出发,到 (i,j) 有 dp[i][j] 条不同的路径,和上一题的主要区别在于增加了障碍,在有障碍的点要令 dp[i][j] = 0 ;
- 确定递推公式:状态转移方程
dp[i][j] = dp[i][j-1] + dp[i-1][j]; ;
dp 数组如何初始化:dp[1][1] = 1; ,其他初始化为 0;- 确定遍历顺序:从上往下、从前往后遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int uniquePathsWithObstacles(vector<vector<int>>& obstacleGrid) {
        int m = obstacleGrid.size();
        int n = obstacleGrid[0].size();
        vector<vector<int>> dp(m+1, vector<int>(n+1, 0));
        dp[1][1] = 1;
        for(int i=1; i<=m; i++){
            for(int j=1; j<=n; j++){
                if(obstacleGrid[i-1][j-1] == 1){
                    dp[i][j] = 0;
                    continue;
                }
                if(i!=1 || j!=1){
                    dp[i][j] = dp[i][j-1] + dp[i-1][j];
                }
            }
        }
        return dp[m][n];
    }
};
- 整数拆分:343.整数拆分
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i] 的定义为:拆分整数 i 后所得到的最大乘积为 dp[i] ;
- 确定递推公式:
- 正整数
i 可以拆分成 j*(i-j)、j*dp[i-j] 这两种方式,此时能够覆盖所有的拆分情况,取出最大值即可。
- 状态转移方程
dp[i] = max(max(j*(i-j), j*dp[i-j]), dp[i]); ;
dp 数组如何初始化:dp[0] = 0; 、dp[1] = 0;、dp[2] = 1;;- 确定遍历顺序:从前往后遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int integerBreak(int n) {
        int dp[59] = {0};
        dp[0] = 0;
        dp[1] = 0;
        dp[2] = 1;
        for(int i=3; i<=n; i++){
            // 当拆分的整数尽可能接近时能得到最大值
            for(int j=1; j<=i/2; j++){
                dp[i] = max(max(j*(i-j), j*dp[i-j]), dp[i]);
            }
        }
        return dp[n];
    }
};
- 不同的二叉搜索树:96.不同的二叉搜索树
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i] 的定义为:由 i 个节点组成的二叉搜索树的种类数量为 dp[i] 种;
dp 数组如何初始化:dp[0] = 1; ;- 确定遍历顺序:从前往后遍历;
- 举例推导
dp 数组符合要求。
- 确定递推公式:
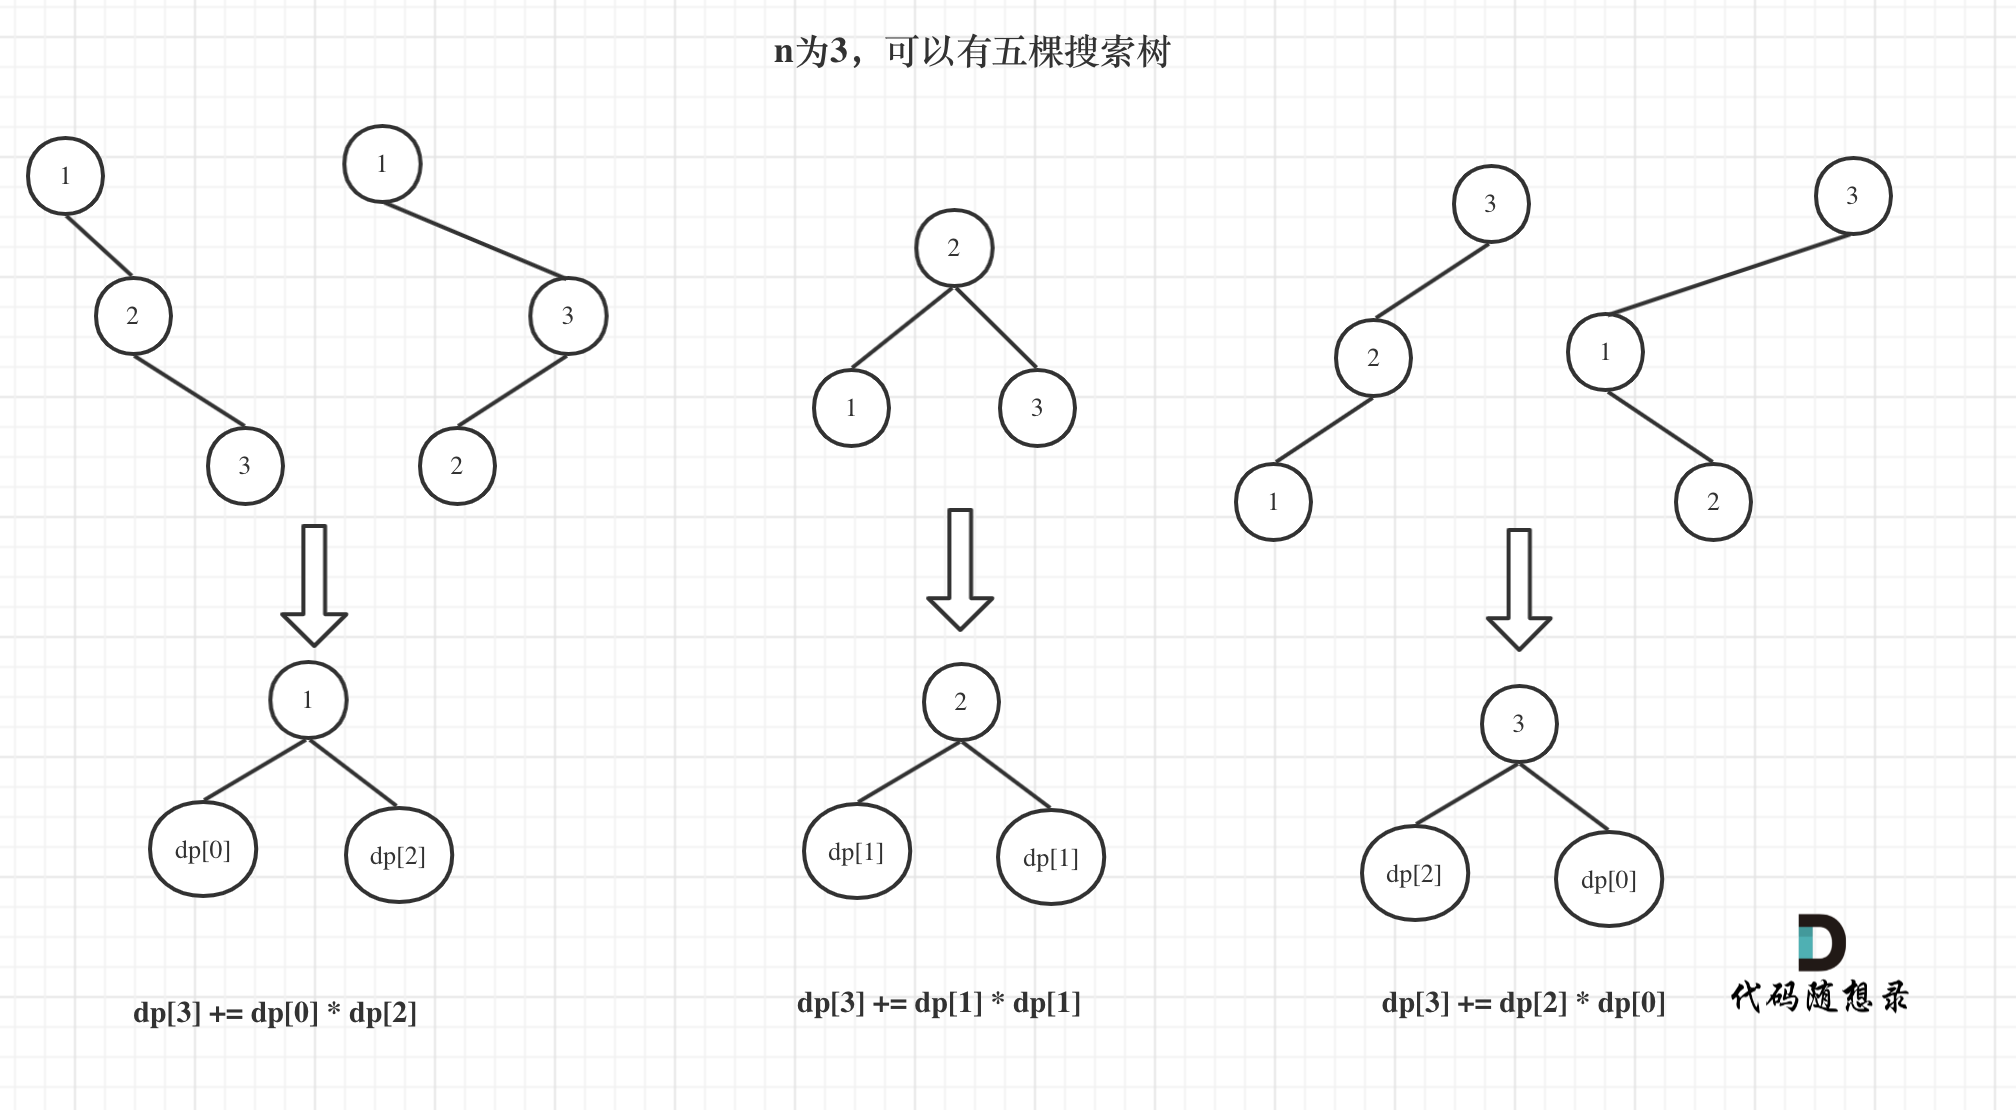
- 二叉搜索树一旦形状确定,其内部节点的填充方法就是唯一确定的(从下方投影看,左到右依次增大),所以这题就是求不同形状的二叉搜索树数量,进而转换成左子树形状种类✖️右子树形状种类;

for(int j=1; j<=i; j++){
    dp[i] += dp[j-1] * dp[i-j];
}class Solution {
public:
int numTrees(int n) {
int dp[20];
dp[0] = 1;
for(int i=1; i<=n; i++){
for(int j=1; j<=i; j++){
dp[i] += dp[j-1] * dp[i-j];
}
}
return dp[n];
}
};
- 携带研究材料:46. 携带研究材料
- 思路:
- 二维递推公式:
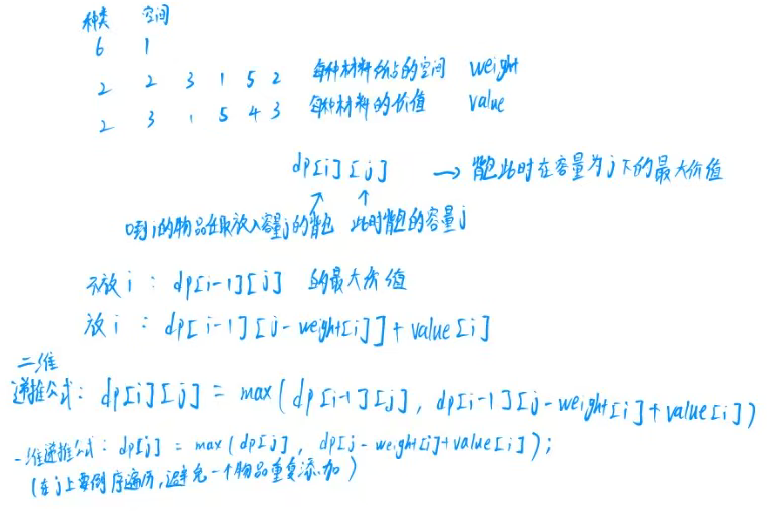
i :表示 0 到 i 的物品任取放入容量 j 的背包中j :表示此时的背包容量dp[i][j] : 背包在容量为 j 的情况下从 0 到 i 的物品中选择装入得到的最大价值。
- 一维递推公式:
i :表示 0 到 i 的物品任取放入容量 j 的背包中j :表示此时的背包容量dp[j] : 背包在容量为 j 的情况下从 0 到 i 的物品中选择装入得到的最大价值。

- 一维递推公式在
j 上要倒序遍历,避免一个物品重复添加。例子:
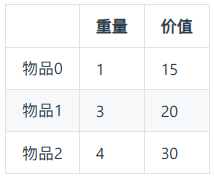
- 举一个例子:物品
0 的重量 weight[0] = 1 ,价值 value[0] = 15
- 如果正序遍历,此时
i=0
dp[1] = dp[1 - weight[0]] + value[0] = 15dp[2] = dp[2 - weight[0]] + value[0] = 30
- 此时
dp[2]就已经是 30 了,意味着物品 0,被放入了两次,所以不能正序遍历。
- 为什么倒序遍历,就可以保证物品只放入一次呢?此时
i=0
- 倒序就是先算
dp[2]
dp[2] = dp[2 - weight[0]] + value[0] = 15 (dp 数组已经都初始化为 0)dp[1] = dp[1 - weight[0]] + value[0] = 15
- 所以从后往前循环,每次取得状态不会和之前取得状态重合,这样每种物品就只取一次了。

#include <cstdio>
#include <vector>
#include <algorithm>

using namespace std;

int main(){
    int m,n;
    scanf("%d %d", &m, &n);
    vector<int> weight(m,0);
    vector<int> value(m,0);
    for(int i=0; i<m; i++){
        scanf("%d", &weight[i]);
    }
    for(int i=0; i<m; i++){
        scanf("%d", &value[i]);
    }
    vector<vector<int>> dp(m, vector<int>(n+1,0));
    // 初始化第一列
    for(int i=0; i<m; i++){
        dp[i][0] = 0;
    }
    // 初始化第一行
    for(int j=1; j<=n; j++){
        if(j<weight[0]) // 背包装不下的情况
            dp[0][j] = 0;
        else
            dp[0][j] = value[0];
    }
    // 递推公式
    for(int i=1; i<m; i++){
        for(int j=0; j<=n; j++){
            if(j<weight[i]) // 背包装不下的情况
                dp[i][j] = dp[i-1][j];
            else
                dp[i][j] = max(dp[i-1][j], dp[i-1][j-weight[i]]+value[i]);
        }
    }
    printf("%d\n", dp[m-1][n]);
    return 0;
}#include <cstdio>
#include <vector>
#include <algorithm>
using namespace std;
int main(){
int m,n;
scanf("%d %d", &m, &n);
vector<int> weight(m,0);
vector<int> value(m,0);
for(int i=0; i<m; i++){
scanf("%d", &weight[i]);
}
for(int i=0; i<m; i++){
scanf("%d", &value[i]);
}
// dp 数组初始化
vector<int> dp(n+1,0);
for(int i=0; i<m; i++){ // 表示物品种类i之前的所有物品在容量为j的背包中的最大价值dp[j]
for(int j=n; j>=weight[i]; j--){ // 背包容量(倒序遍历避免物品重复添加)
dp[j] = max(dp[j], dp[j-weight[i]]+value[i]);
}
}
printf("%d\n", dp[n]);
return 0;
}
- 分割等和子集:416.分割等和子集
- 思路:
- 这道题目可以看成是
0 - 1 背包问题的变式,题目只要求将一个数组分割成两个子集,使得两个子集的元素和相等。那么可以将背包容量设定为数组总和 sum 的一半,即 sum/2,各个物品的重量和价值都是 nums 数组的元素,若能刚好装下 sum/2 容量的背包则返回 true,否则返回 false。
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[j] 的定义为:背包在容量为 j 的情况下从 0 到 i 的物品中选择装入得到的最大重量。
- 确定递推公式(与
0 - 1 背包问题一致):
- 状态转移方程
dp[j] = max(dp[j], dp[j-nums[i]]+nums[i]); ;
dp 数组如何初始化:全部初始化成 0;- 确定遍历顺序:在
i 上正序遍历,在 j 上倒序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    bool canPartition(vector<int>& nums) {
        int sum = 0;
        for(int i=0; i<nums.size(); i++){
            sum+=nums[i];
        }
        if(sum%2 == 1) // 求和之后是奇数
            return false;
        // 背包容量是 sum/2
        int target = sum/2;
        vector<int> dp(target+1, 0);
        for(int i=0; i<nums.size(); i++){
            for(int j=target; j>=nums[i]; j--){
                dp[j] = max(dp[j], dp[j-nums[i]]+nums[i]);
                if(dp[target] == target)
                    return true;
            }
        }
        return false;
    }
};
- 最后一块石头的重量 II:1049.最后一块石头的重量II
- 思路:
- 这道题目同样可以看成是
0 - 1 背包问题的变式,上一题是求背包是否正好装满,而本题是求背包最多能装多少。那么可以将背包容量设定为数组总和 sum 的一半,即 target = sum/2,各个物品的重量和价值都是 stones 数组的元素,得到在该容量下能装的最大重量,最后 sum - dp[target] - dp[target] 即得到最小的结果。
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[j] 的定义为:背包在容量为 j 的情况下从 0 到 i 的物品中选择装入得到的最大重量。
- 确定递推公式(与
0 - 1 背包问题一致):
- 状态转移方程
dp[j] = max(dp[j], dp[j-nums[i]]+nums[i]); ;
dp 数组如何初始化:全部初始化成 0;- 确定遍历顺序:在
i 上正序遍历,在 j 上倒序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int lastStoneWeightII(vector<int>& stones) {
        int sum = 0;
        for(int i=0; i<stones.size(); i++){
            sum += stones[i];
        }
        int target = sum/2;
        vector<int> dp(target+1, 0);
        for(int i=0; i<stones.size(); i++){
            for(int j=target; j>=stones[i]; j--){
                dp[j] = max(dp[j], dp[j-stones[i]]+stones[i]);
            }
        }
        return sum - dp[target] - dp[target];
    }
};
- 目标和:494.目标和
- 思路:
- 这道题目同样可以看成是
0 - 1 背包问题的变式,假设加法的总和为 pos,那么减法对应的总和就是 neg = pos - sum 。所以我们要求的是 pos + neg = target,pos = (target + sum)/2,此时问题就转化为,用 nums 装满容量为 pos 的背包,有几种方法。
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[j] 的定义为:dp[j] 表示装满容量为 j 的背包有 dp[j] 种方法。
- 确定递推公式:
dp[j] 由所有 dp[j-nums[i]] 相加得到,后续要装满容量为 j 的背包有多少种方法都是用该递推公式。- 状态转移方程
dp[j] += dp[j-nums[i]]; ;
dp 数组如何初始化:dp[0] = 1; 、其余初始化成 0;- 确定遍历顺序:在
i 上正序遍历,在 j 上倒序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int findTargetSumWays(vector<int>& nums, int target) {
       int sum = 0;
        for(int i=0; i<nums.size(); i++){
            sum+=nums[i];
        }
        /*
        pos + neg = target
        pos - neg = sum -> neg = pos - sum
        pos + pos - sum = target -> pos = (target + sum)/2
        */
        int ans = 0;
        if(abs(target)>sum)
            return 0;
        if((target+sum)%2 == 1)
            return 0;
        int pos = (target+sum)/2;
        vector<int> dp(pos+1, 0);
        dp[0] = 1;
        for(int i=0; i<nums.size(); i++){
            for(int j=pos; j>=nums[i]; j--){
                dp[j] += dp[j-nums[i]]; // dp[j] 表示装满容量为j的背包有 dp[j] 种方法
            }
        }
        return dp[pos];
    }
};
- 一和零:474.一和零
- 思路:
- 这道题目同样可以看成是
0 - 1 背包问题的变式,只不过这个背包有两个维度,一个是 m 一个是 n,而不同长度的字符串就是不同大小的待装物品。
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][j]:最多有 i 个 0 和 j 个 1 的 strs 的最大子集的大小为 dp[i][j] 。
- 确定递推公式:
dp[i-x][j-y]+1 的含义是容量为 [i-x][j-y] 的背包加上有 x 个 0 和 y 个 1 的字符串后子集的元素数量要 +1 。- 状态转移方程
dp[i][j] = max(dp[i][j], dp[i-x][j-y]+1); ;
dp 数组如何初始化:全部初始化成 0;- 确定遍历顺序:在
i 上正序遍历,在 j 上倒序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    void CountStr(int& x, int& y, string str){
        for(int i=0; i<str.size(); i++){
            if(str[i] == '0')
                x++;
            else
                y++;
        }
    }

    int findMaxForm(vector<string>& strs, int m, int n) {
        vector<vector<int>> dp(m+1, vector<int> (n+1,0));
        for(int k=0; k<strs.size(); k++){
            int x=0, y=0; // x,y 分别表示字符串中0和1的个数
            CountStr(x, y, strs[k]);
            for(int i=m; i>=x; i--){
                for(int j=n; j>=y; j--){
                    dp[i][j] = max(dp[i][j], dp[i-x][j-y]+1);
                }
            }
        }
        return dp[m][n];
    }
};
- 携带研究材料:52.携带研究材料
- 思路:
- 唯一和
0 - 1 背包不同之处在于遍历背包重量 j 采用正序。
- 代码:
#include <cstdio>
#include <vector>
#include <algorithm>

using namespace std;

int main(){
    int n,v;
    scanf("%d %d", &n, &v);
    vector<int> weight(n);
    vector<int> value(n);
    for(int i=0; i<n; i++){
        scanf("%d %d", &weight[i], &value[i]);
    }
    vector<int> dp(v+1, 0);
    for(int i=0; i<n; i++){
        for(int j=weight[i]; j<=v; j++){ // 唯一和 0 - 1 背包不同之处在于遍历背包重量 j 采用正序。
            dp[j] = max(dp[j], dp[j-weight[i]]+value[i]);
        }
    }
    printf("%d\n", dp[v]);
    return 0;
}
- 零钱兑换 II:518.零钱兑换 II
- 思路:
- 这道题目是完全背包问题的变式,求的是装满容量为
j 的背包有多少种方式。
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[j]:装满容量为 j 的背包有 dp[j] 种方式。
- 确定递推公式:
dp[j] 由所有 dp[j-nums[i]] 相加得到,后续要装满容量为 j 的背包有多少种方法都是用该递推公式。- 状态转移方程
dp[j] += dp[j-nums[i]]; ;
- 需要注意的是要加上
if (dp[j] < INT_MAX - dp[j - coins[i]]) 来防止相加数据超 int 。
dp 数组如何初始化:dp[0] = 1; 、其余初始化成 0;- 确定遍历顺序:在
i 上正序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int change(int amount, vector<int>& coins) {
        vector<int> dp(amount+1, 0);
        dp[0] = 1;
        for(int i=0; i<coins.size(); i++){
            for(int j=coins[i]; j<=amount; j++){
                if (dp[j] < INT_MAX - dp[j - coins[i]]) // 防止相加数据超int
                    dp[j] += dp[j-coins[i]];
            }
        }
        return dp[amount];
    }
};
- 组合总和 Ⅳ:377.组合总和 Ⅳ
- 思路:
- 这道题目是完全背包问题的变式,求的是装满容量为
j 的背包有多少种方式。但是和上一题不同的是不同的遍历顺序有不同的结果:
- 先背包再物品,求的是排列数;
- 先物品再背包,求的是组合数。
- 可以这么理解,先遍历物品的话
0 号物品将不会出现在后面,因此求的是组合数。
- 本题求的是排列数,因此采用先背包再物品的遍历顺序。
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[j]:装满容量为 j 的背包有 dp[j] 种方式。
- 确定递推公式:
dp[j] 由所有 dp[j-nums[i]] 相加得到,后续要装满容量为 j 的背包有多少种方法都是用该递推公式。- 状态转移方程
dp[j] += dp[j-nums[i]]; ;
- 需要注意的是要加上
if (dp[j] < INT_MAX - dp[j - coins[i]]) 来防止相加数据超 int 。
dp 数组如何初始化:dp[0] = 1; 、其余初始化成 0;- 确定遍历顺序:在
i 上正序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int combinationSum4(vector<int>& nums, int target) {
        vector<int> dp(target+1, 0);
        dp[0] = 1;
        for(int i=0; i<=target; i++){
            for(int j=0; j<nums.size(); j++){
                if(i>=nums[j] && dp[i] <= INT_MAX - dp[i-nums[j]])
                    dp[i] += dp[i-nums[j]];
            }
        }
        return dp[target];
    }
};
- 爬楼梯(进阶版):56.爬楼梯(进阶版)
- 思路:
- 这道题和上一道题目完全一样,注意求的是排列数,因此采用先背包再物品的遍历顺序。
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[j]:装满容量为 j 的背包有 dp[j] 种方式。
- 确定递推公式:
dp[j] 由所有 dp[j-nums[i]] 相加得到,后续要装满容量为 j 的背包有多少种方法都是用该递推公式。- 状态转移方程
dp[j] += dp[j-nums[i]]; ;
- 需要注意的是要加上
if (dp[j] < INT_MAX - dp[j - coins[i]]) 来防止相加数据超 int 。
dp 数组如何初始化:dp[0] = 1; 、其余初始化成 0;- 确定遍历顺序:在
i 上正序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
#include <cstdio>
#include <vector>
#include <algorithm>

using namespace std;

int main(){
    int n, m;
    scanf("%d %d",&n, &m);
    vector<int> dp(n+1, 0);
    dp[0] = 1;
    // 先遍历楼梯
    for(int i=0; i<=n; i++){
        for(int j=1; j<=m; j++){
            if(i>=j)
                dp[i] += dp[i-j];
        }
    }
    printf("%d\n", dp[n]);
    return 0;
}
- 零钱兑换:322.零钱兑换
- 思路:
- 题目中说每种硬币的数量是无限的,可以看出是典型的完全背包问题。
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[j]:凑足总额为 j 所需钱币的最少个数为 dp[j] 。
- 确定递推公式:
dp[j] = min(dp[j], dp[j-coins[i]]+1);
dp 数组如何初始化:dp[0] = 0; 、其余初始化成 INT_NAX;- 确定遍历顺序:在
i 上正序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int coinChange(vector<int>& coins, int amount) {
        vector<int> dp(amount+1, INT_MAX);
        dp[0] = 0;
        for(int i=0; i<coins.size(); i++){
            for(int j=coins[i]; j<=amount; j++){
                if (dp[j - coins[i]] != INT_MAX) // 如果dp[j - coins[i]]是初始值则跳过
                    dp[j] = min(dp[j], dp[j-coins[i]]+1);
            }
        }
        if(dp[amount] == INT_MAX)
            return -1;
        else
            return dp[amount];
    }
};class Solution {
public:
int numSquares(int n) {
vector<int> dp(n+1, INT_MAX);
dp[0] = 0;
for(int i=0; i<=n; i++){
for(int j=i*i; j<=n; j++){
if(dp[j-i*i] != INT_MAX) // 如果dp[j - coins[i]]是初始值则跳过
dp[j] = min(dp[j], dp[j-i*i]+1);
}
}
return dp[n];
}
};
- 单词拆分:139.单词拆分
- 思路:
- 单词就是物品,字符串
s 就是背包,单词能否组成字符串 s,就是问物品能不能把背包装满。拆分时可以重复使用字典中的单词,说明就是一个完全背包!
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i] : 字符串长度为 i 的话,dp[i] 为 true,表示可以拆分为一个或多个在字典中出现的单词。
- 确定递推公式:如果确定
dp[j] 是 true,且 [j, i] 这个区间的子串出现在字典里,那么 dp[i] 一定是 true。
dp 数组如何初始化:dp[0] = true; 、其余初始化成 false;- 确定遍历顺序:在
i 上正序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。
- 注意代码中的
unordered_set<string> 和 word_dict.find(s.substr(j, i-j)) != word_dict.end() 相关代码的使用!
- 代码:
class Solution {
public:
    bool wordBreak(string s, vector<string>& wordDict) {
        unordered_set<string> word_dict(wordDict.begin(), wordDict.end());
        vector<bool> dp(s.size()+1, false);
        dp[0] = true;
        for(int i=1; i<=s.size(); i++){ // 求排列序,先背包
            for(int j=0; j<i; j++){ // 再物品
                if(word_dict.find(s.substr(j, i-j)) != word_dict.end() && dp[j] == true)
                    dp[i] = true;
            }
        }
        return dp[s.size()];
    }
};
- 打家劫舍:198.打家劫舍
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i] : 考虑下标 i(包括 i)以内的房屋,最多可以偷窃的金额为 dp[i]。
- 确定递推公式:
dp[i] = max(dp[i-2]+nums[i], dp[i-1]); 。
- 最大金额要么是
dp[i-2] 家的金额加上 nums[i],要么是不偷第 i 家,最大金额是 dp[i-1],这两者取最大值即可。
dp 数组如何初始化:dp[0] = nums[0]; 、dp[1] = max(dp[0], nums[1]);、其余初始化成 false;- 确定遍历顺序:在
i 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int rob(vector<int>& nums) {
        if(nums.size() == 1)
            return nums[0];
        if(nums.size() == 2)
            return max(nums[0], nums[1]);
        vector<int> dp(nums.size(), 0);
        dp[0] = nums[0];
        dp[1] = max(dp[0], nums[1]);
        for(int i=2; i<nums.size(); i++){
            dp[i] = max(dp[i-2]+nums[i], dp[i-1]);
        }
        return dp[nums.size()-1];
    }
};


- 由于情况二和情况三都包含了情况一了,所以只考虑情况二和情况三就可以了。因此分别求情况二和情况三的值,返回其中的最大值即可。
- 代码:
class Solution {
public:
    // 打家劫舍一的代码
    int rob_1(vector<int>& nums, int start, int end){
        if(end == start)
            return nums[start];
        if(end - start == 1)
            return max(nums[start], nums[start+1]);
        vector<int> dp(nums.size(), 0);
        dp[start] = nums[start];
        dp[start+1] = max(dp[start], nums[start+1]);
        for(int i=start+2; i<=end; i++){
            dp[i] = max(dp[i-2]+nums[i], dp[i-1]);
        }
        return dp[end];
    }

    int rob(vector<int>& nums) {
        if(nums.size() == 1)
            return nums[0];
        int num_1 = rob_1(nums, 0, nums.size()-2);
        int num_2 = rob_1(nums, 1, nums.size()-1);
        return max(num_1, num_2);
    }
};
- 打家劫舍 III:337.打家劫舍III
- 思路:
- 1、确定递归函数的参数和返回值:这里我们要求一个节点偷与不偷的两个状态所得到的金钱,那么返回值就是一个长度为
2 的数组。
- 2、确定终止条件:在遍历的过程中,如果遇到空节点的话,很明显,无论偷还是不偷都是
0,所以就返回 {0, 0} 。
- 3、确定遍历顺序:
- 首先明确的是使用后序遍历。因为要通过递归函数的返回值来做下一步计算。
- 通过递归左节点,得到左节点偷与不偷的金钱。
- 通过递归右节点,得到右节点偷与不偷的金钱。
- 4、确定单层递归的逻辑:
- 如果是偷当前节点,那么左右孩子就不能偷,
dp[1] = root->val + val_1[0] + val_2[0];
- 如果不偷当前节点,那么左右孩子就可以偷,至于到底偷不偷一定是选一个最大的,所以:
dp[0] = max (val_1[0], val_1[1]) + max (val_2[0], val_2[1]);
- 最后当前节点的状态就是
{dp[0], dp[1]} 。即:{ 不偷当前节点得到的最大金钱,偷当前节点得到的最大金钱 }。
- 代码:
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution {
public:
    vector<int> robTree(TreeNode* root){
        // 终止条件
        if(root == nullptr)
            return {0,0};
        vector<int> val_1 = robTree(root->left);
        vector<int> val_2 = robTree(root->right);
        vector<int> dp(2, 0);
        // 不偷该节点
        dp[0] = max(val_1[0], val_1[1]) + max(val_2[0], val_2[1]);
        // 偷该节点
        dp[1] = root->val + val_1[0] + val_2[0];
        return dp;
    }

    int rob(TreeNode* root) {
        vector<int> dp = robTree(root);
        return max(dp[0], dp[1]);
    }
};
- 买卖股票的最佳时机:121.买卖股票的最佳时机
- 贪心思路:
- 因为股票就买卖一次,那么贪心的想法很自然就是取最左最小值,取最右最大值,那么得到的差值就是最大利润。
- 贪心思路代码:
class Solution {
public:
    int maxProfit(vector<int>& prices) {
        int low = INT_MAX;
        int result = 0;
        for (int i = 0; i < prices.size(); i++) {
            low = min(low, prices[i]);  // 取最左最小价格
            result = max(result, prices[i] - low); // 直接取最大区间利润
        }
        return result;
    }
};
- 动规思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][0] 表示不持有股票,dp[i][1] 表示持有股票。
- 确定递推公式:
- 第
i 天如果不持有股票:dp[i][0] = max(dp[i-1][0], dp[i-1][1]+prices[i]);
- 第
i 天如果持有股票:dp[i][1] = max(dp[i-1][1], 0-prices[i]);
dp 数组如何初始化:dp[0][0] = 0; 、dp[0][1] = 0-prices[0]; 、其余初始化成 0;- 确定遍历顺序:在
i 上正序遍历;
- 举例推导
dp 数组符合要求。
- 动规思路代码:
class Solution {
public:
    int maxProfit(vector<int>& prices) {
        // dp[i][0]表示不持有股票,dp[i][1]表示持有股票
        vector<vector<int>> dp(prices.size(), vector<int>(2, 0));
        dp[0][0] = 0;
        dp[0][1] = 0-prices[0];
        for(int i=1; i<prices.size(); i++){
            dp[i][0] = max(dp[i-1][0], dp[i-1][1]+prices[i]);
            dp[i][1] = max(dp[i-1][1], 0-prices[i]);
        }
        return dp[prices.size()-1][0];
    }
};
- 买卖股票的最佳时机 II:122.买卖股票的最佳时机II
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][0] 表示不持有股票,dp[i][1] 表示持有股票。
- 确定递推公式:
- 第
i 天如果不持有股票:dp[i][0] = max(dp[i-1][1]+prices[i], dp[i-1][0]);
- 第
i 天如果持有股票:dp[i][1] = max(dp[i-1][0]-prices[i], dp[i-1][1]);
dp 数组如何初始化:dp[0][0] = 0; 、dp[0][1] = 0-prices[0]; 、其余初始化成 0;- 确定遍历顺序:在
i 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int maxProfit(vector<int>& prices) {
        if(prices.size() == 1)
            return 0;
        // dp[i][0] 表示未持有股票的总收益 dp[i][1] 表示持有股票的总收益
        vector<vector<int>> dp(prices.size(), vector<int>(2,0));
        dp[0][1] = 0-prices[0];
        for(int i=1; i<prices.size(); i++){
            dp[i][0] = max(dp[i-1][1]+prices[i], dp[i-1][0]);
            dp[i][1] = max(dp[i-1][0]-prices[i], dp[i-1][1]);
        }
        return dp[prices.size()-1][0];
    }
};
- 买卖股票的最佳时机 III:123.买卖股票的最佳时机III
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][0] 表示不操作,dp[i][1] 表示第一次持有股票,dp[i][2] 表示第一次卖出股票,dp[i][3] 表示第二次持有股票,dp[i][4] 表示第二次卖出股票;
- 确定递推公式:
- 第
i 天如果操作:dp[i][0] = dp[i-1][0];
- 第
i 天如果第一次持有股票:dp[i][1] = max(dp[i-1][1], dp[i-1][0]-prices[i]);
- 第
i 天如果第一次卖出股票:dp[i][2] = max(dp[i-1][2], dp[i-1][1]+prices[i]);
- 第
i 天如果第二次持有股票:dp[i][3] = max(dp[i-1][3], dp[i-1][2]-prices[i]);
- 第
i 天如果第二次卖出股票:dp[i][4] = max(dp[i-1][4], dp[i-1][3]+prices[i]);
dp 数组如何初始化:dp[0][0] = 0; 、dp[0][1] = 0-prices[0]; 、dp[0][2] = 0; 、dp[0][3] = 0-prices[0]; 、dp[0][4] = 0; 、其余初始化成 0;- 确定遍历顺序:在
i 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int maxProfit(vector<int>& prices) {
        if(prices.size() == 1)
            return 0;
        vector<vector<int>> dp(prices.size(), vector<int>(5,0));
        dp[0][0] = 0; // 0 代表不操作
        dp[0][1] = 0-prices[0]; // 1 代表第一次持有
        dp[0][2] = 0; // 2 代表第一次卖出
        dp[0][3] = 0-prices[0]; // 3 代表第第二次持有
        dp[0][4] = 0; // 4 代表第二次卖出
        for(int i=1; i<prices.size(); i++){
            dp[i][0] = dp[i-1][0];
            dp[i][1] = max(dp[i-1][1], dp[i-1][0]-prices[i]);
            dp[i][2] = max(dp[i-1][2], dp[i-1][1]+prices[i]);
            dp[i][3] = max(dp[i-1][3], dp[i-1][2]-prices[i]);
            dp[i][4] = max(dp[i-1][4], dp[i-1][3]+prices[i]);
        }
        return dp[prices.size()-1][4];
    }
};class Solution {
public:
int maxProfit(int k, vector<int>& prices) {
if(prices.size() == 1)
return 0;
vector<vector<int>> dp(prices.size(), vector<int>(2*k+1, 0));
// 初始化
dp[0][0] = 0;
for(int j=1; j<=2*k; j+=2){
dp[0][j] = 0-prices[0];
}
// 遍历
for(int i=1; i<prices.size(); i++){
dp[i][0] = dp[i-1][0];
for(int j=1; j<=2*k; j++){
if(j%2 == 1)
dp[i][j] = max(dp[i-1][j], dp[i-1][j-1]-prices[i]);
else
dp[i][j] = max(dp[i-1][j], dp[i-1][j-1]+prices[i]);
}
}
return dp[prices.size()-1][2*k];
}
};
- 最佳买卖股票时机含冷冻期:309.最佳买卖股票时机含冷冻期
- 思路:
- 核心在于需要划分出四个状态:持有股票、卖出状态(过了冷冻期可以买入)、具体卖出的时候、冷冻期。梳理清楚这四个状态的关系即可写出递推公式。
- 代码:
class Solution {
public:
    int maxProfit(vector<int>& prices) {
        vector<vector<int>> dp(prices.size(), vector<int>(4, 0));
        dp[0][0] = 0-prices[0]; // 持有股票
        dp[0][1] = 0; // 卖出状态(过了冷冻期可以买入)
        dp[0][2] = 0; // 具体卖出的时候
        dp[0][3] = 0; // 冷冻期
        for(int i=1; i<prices.size(); i++){
            dp[i][0] = max(dp[i-1][0], max(dp[i-1][1]-prices[i], dp[i-1][3]-prices[i]));
            dp[i][1] = max(dp[i-1][1], dp[i-1][3]);
            dp[i][2] = dp[i-1][0]+prices[i];
            dp[i][3] = dp[i-1][2];
        }
        return max(dp[prices.size()-1][1], max(dp[prices.size()-1][2], dp[prices.size()-1][3]));
    }
};
- 最长递增子序列:300.最长递增子序列
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i] 表示 i 之前包括 i 的以 nums[i] 结尾的最长递增子序列的长度。
- 确定递推公式:
j 要从 0 循环到 i,判断 nums[i] > nums[j] 说明满足递增子序列,因此采用递推公式 dp[i] = max(dp[i], dp[j]+1); 。
dp 数组如何初始化:全部初始化成 1;- 确定遍历顺序:在
i 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int lengthOfLIS(vector<int>& nums) {
        // 以nums[i]结尾的最长递增子序列数
        vector<int> dp(nums.size(), 1);
        int ans = dp[0];
        for(int i=1; i<nums.size(); i++){
            for(int j=0; j<i; j++){
                if(nums[i] > nums[j])
                    dp[i] = max(dp[i], dp[j]+1);
            }
            if(dp[i] > ans)
                ans = dp[i];
        }
        return ans;
    }
};
- 最长连续递增子序列:674.最长连续递增子序列
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i] 表示 i 之前包括 i 的以 nums[i] 结尾的最长连续递增子序列的长度。
- 确定递推公式:
- 和上一题的最大不同在于本题要求连续的递增子序列,因此
i 只需要和它的前一个元素 i-1 来比较即可,因此递推公式为当 nums[i] > nums[i-1] 时,有 dp[i] = dp[i-1]+1;。
dp 数组如何初始化:全部初始化成 1;- 确定遍历顺序:在
i 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int findLengthOfLCIS(vector<int>& nums) {
        // 以nums[i]结尾的最长连续递增子序列数
        vector<int> dp(nums.size(), 1);
        int ans = dp[0];
        for(int i=1; i<nums.size(); i++){
            if(nums[i]>nums[i-1])
                dp[i] = dp[i-1]+1;
            if(dp[i]>ans)
                ans = dp[i];
        }
        return ans;
    }
};
- 最长重复子数组:718.最长重复子数组
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][j] 表示以 nums1[i-1] 结尾和 nums2[j-1] 结尾的最长重复子数组长度。
- 确定递推公式:
- 当
nums1[i-1] == nums2[j-1] 的时候,dp[i][j] = dp[i-1][j-1]+1;
dp 数组如何初始化:全部初始化成 0;
- 根据
dp[i][j] 的定义,dp[i][0] 和 dp[0][j] 其实都是没有意义的!但 dp[i][0] 和 dp[0][j] 要初始值,因为为了方便递归公式 dp[i][j] = dp[i-1][j-1] + 1; 所以 dp[i][0] 和 dp[0][j] 初始化为 0。
- 确定遍历顺序:在
i 上正序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int findLength(vector<int>& nums1, vector<int>& nums2) {
        // dp[i][j] 以 nums1[i-1] 结尾和 nums2[j-1] 结尾的最长重复子数组长度
        vector<vector<int>> dp(nums1.size()+1, vector<int>(nums2.size()+1, 0));
        int ans = 0;
        for(int i=1; i<=nums1.size(); i++){
            for(int j=1; j<=nums2.size(); j++){
                if(nums1[i-1] == nums2[j-1])
                    dp[i][j] = dp[i-1][j-1]+1;
            if(dp[i][j] > ans)
                ans = dp[i][j];
            }
        }
        return ans;
    }
};
- 最长公共子序列:1143.最长公共子序列
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][j] 表示以 nums1[i-1] 结尾和 nums2[j-1] 结尾的最长公共子序列数。
- 确定递推公式:
- 当
nums1[i-1] == nums2[j-1] 的时候,dp[i][j] = dp[i-1][j-1]+1;。
- 否则,
dp[i][j] = max(dp[i][j-1], dp[i-1][j]);
dp 数组如何初始化:全部初始化成 0;
- 根据
dp[i][j] 的定义,dp[i][0] 和 dp[0][j] 其实都是没有意义的!但 dp[i][0] 和 dp[0][j] 要初始值,因为为了方便递归公式 dp[i][j] = dp[i-1][j-1] + 1; 所以 dp[i][0] 和 dp[0][j] 初始化为 0。
- 确定遍历顺序:在
i 上正序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int longestCommonSubsequence(string text1, string text2) {
        vector<vector<int>> dp(text1.size()+1, vector<int>(text2.size()+1, 0));
        for(int i=1; i<=text1.size(); i++){
            for(int j=1; j<=text2.size(); j++){
                if(text1[i-1] == text2[j-1])
                    dp[i][j] = dp[i-1][j-1]+1;
                else
                    dp[i][j] = max(dp[i][j-1], dp[i-1][j]);
            }
        }
        return dp[text1.size()][text2.size()];
    }
};
- 不相交的线:1035.不相交的线
- 思路:
- 直线不能相交,这就是说明在字符串
nums1 中找到一个与字符串 nums2 相同的子序列,且这个子序列不能改变相对顺序,只要相对顺序不改变,连接相同数字的直线就不会相交。也就将题目转化为了求最长公共子序列问题。
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][j] 表示以 nums1[i-1] 结尾和 nums2[j-1] 结尾的最长公共子序列数。
- 确定递推公式:
- 当
nums1[i-1] == nums2[j-1] 的时候,dp[i][j] = dp[i-1][j-1]+1;。
- 否则,
dp[i][j] = max(dp[i][j-1], dp[i-1][j]);
dp 数组如何初始化:全部初始化成 0;
- 根据
dp[i][j] 的定义,dp[i][0] 和 dp[0][j] 其实都是没有意义的!但 dp[i][0] 和 dp[0][j] 要初始值,因为为了方便递归公式 dp[i][j] = dp[i-1][j-1] + 1; 所以 dp[i][0] 和 dp[0][j] 初始化为 0。
- 确定遍历顺序:在
i 上正序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int maxUncrossedLines(vector<int>& nums1, vector<int>& nums2) {
        // dp[i][j] 表示 nums1[i-1] 和 nums2[j-1] 结尾的最长公共子序列
        vector<vector<int>> dp(nums1.size()+1, vector<int>(nums2.size()+1, 0));
        int ans = 0;
        for(int i=1; i<=nums1.size(); i++){
            for(int j=1; j<=nums2.size(); j++){
                if(nums1[i-1] == nums2[j-1])
                    dp[i][j] = dp[i-1][j-1]+1;
                else
                    dp[i][j] = max(dp[i-1][j], dp[i][j-1]);
            }
        }
        return dp[nums1.size()][nums2.size()];
    }
};
- 最大子数组和:53.最大子数组和
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i] 表示以 nums[i] 结尾的最大子数组和。
- 确定递推公式:
- 以
nums[i] 结尾的最大子数组和:
- 要么是之前的最大子数组和加上自身的
nums[i],即 dp[i-1]+nums[i] ;
- 要么是之前的最大子数组和不再计算,只计算自身的
nums[i];
- 最终两者取较大值:
dp[i] = max(nums[i], dp[i-1]+nums[i]);。
dp 数组如何初始化:除了 dp[0] = nums[0] ,其他全部初始化成 INT_MIN;- 确定遍历顺序:在
i 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    int maxSubArray(vector<int>& nums) {
        if(nums.size() == 1)
            return nums[0];
        // dp[i] 以元素nums[i]为结尾的最大子数组和
        vector<int> dp(nums.size(), INT_MIN);
        dp[0] = nums[0];
        int ans = dp[0];
        for(int i=1; i<nums.size(); i++){
            dp[i] = max(nums[i], dp[i-1]+nums[i]);
            if(dp[i] > ans)
                ans = dp[i];
        }
        return ans;
    }
};
- 判断子序列:392.判断子序列
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][j] 表示以 s[i-1] 结尾和 t[j-1] 结尾的相同子序列的长度。
- 确定递推公式:
- 当
s[i-1] == t[j-1] 的时候,dp[i][j] = dp[i-1][j-1]+1;,可以理解为是将 s[i-1] 和 t[j-1] 删除后的子序列的长度加 1 。
- 否则,
dp[i][j] = dp[i][j-1];,可以理解为与删除 t 字符串的最后一个元素的相同子序列的长度一致。
dp 数组如何初始化:全部初始化成 0;
- 根据
dp[i][j] 的定义,dp[i][0] 和 dp[0][j] 其实都是没有意义的!但 dp[i][0] 和 dp[0][j] 要初始值,因为为了方便递归公式 dp[i][j] = dp[i-1][j-1] + 1; 所以 dp[i][0] 和 dp[0][j] 初始化为 0。
- 确定遍历顺序:在
i 上正序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    bool isSubsequence(string s, string t) {
        vector<vector<int>> dp(s.size()+1, vector<int>(t.size()+1, 0));
        dp[0][0] = 0;
        for(int i=1; i<=s.size(); i++){
            for(int j=1; j<=t.size(); j++){
                if(s[i-1] == t[j-1]){
                    dp[i][j] = dp[i-1][j-1]+1;
                }else{
                    dp[i][j] = dp[i][j-1]; // 可以理解为与删除t字符串的最后一个元素的相同子序列的长度一致
                }
            }
        }
        if(dp[s.size()][t.size()] == s.size())
            return true;
        else
            return false;
    }
};
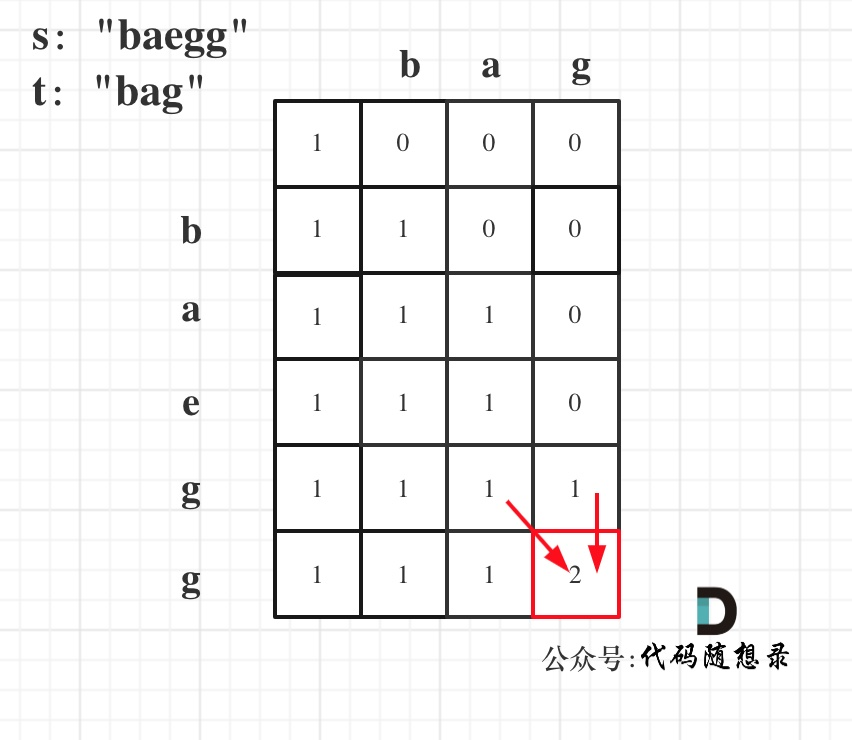
- 不同的子序列:115.不同的子序列
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][j] 表示以 s[i-1] 元素结尾的 s 中有多少个以 t[j-1] 为结尾的子字符串。
- 确定递推公式:
- 当
s[i-1] == t[j-1] 的时候,dp[i][j] = dp[i-1][j-1] + dp[i-1][j];,可以理解为是将 s[i-1] 和 t[j-1] 删除后 s 中包含 t 的数量加上将 s[i-1] 删除后 s 中包含 t 的数量。
- 否则,
dp[i][j] = dp[i][j-1];,可以理解为与将 s[i-1] 删除后 s 中包含 t 的数量相等。
dp 数组如何初始化:全部初始化成 0;
- 根据
dp[i][j] 的定义,dp[i][0] 表示 s 中至少有一个空字符串和 dp[0][j] 表示 s 为空时没有子字符串!
- 确定遍历顺序:在
i 上正序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。

class Solution {
public:
    int numDistinct(string s, string t) {
        // dp[i][j] 以i-1元素结尾的s中有多少个以j-1为结尾的子字符串
        vector<vector<uint64_t>> dp(s.size()+1, vector<uint64_t>(t.size()+1, 0));
        for(int i=0; i<=s.size(); i++)
            dp[i][0] = 1; // s中至少有一个空字符串
        for(int j=1; j<=t.size(); j++)
            dp[0][j] = 0; // s为空时没有子字符串
        for(int i=1; i<=s.size(); i++){
            for(int j=1; j<=t.size(); j++){
                if(s[i-1] == t[j-1])
                    dp[i][j] = dp[i-1][j-1] + dp[i-1][j];
                else
                    dp[i][j] = dp[i-1][j];
            }
        }
        return dp[s.size()][t.size()];
    }
};
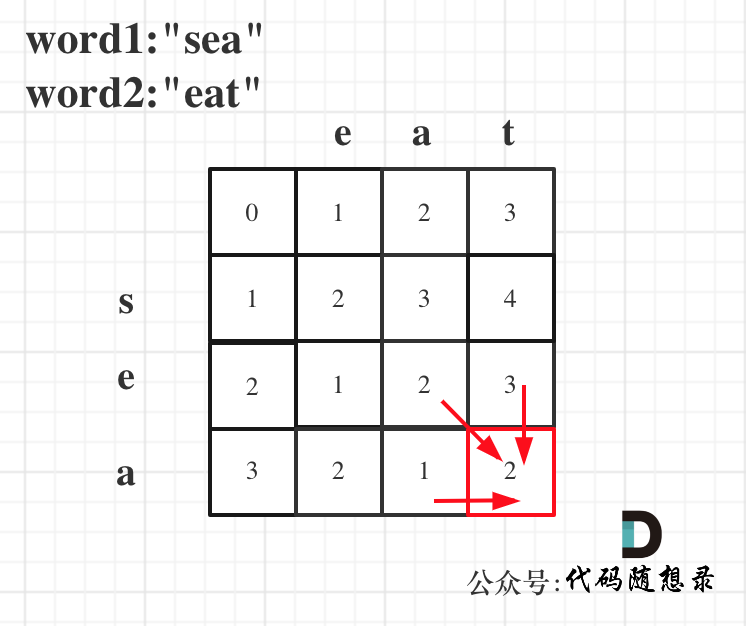
- 两个字符串的删除操作:583.两个字符串的删除操作
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][j] 表示以 word1[i-1] 为结尾的字符串 word1,和以 word2[j-1] 结尾的字符串 word2,想要达到相等,所需要删除元素的最少次数。
- 确定递推公式:
- 当
word1[i-1] == word2[j-1] 的时候,dp[i][j] = dp[i-1][j-1];,可以理解为是将 word1[i-1] 和 word2[j-1] 删除后使得两个字符串相等的最少次数。
- 否则,
dp[i][j] = min(dp[i-1][j], dp[i][j-1])+1;,可以理解为前一个状态 dp[i-1][j] 或者 dp[i][j-1] 的更小者需要通过 dp[i][j] 的一次删除操作完成。
dp 数组如何初始化:dp[i][0] 初始化为 i,dp[0][j] 初始化为 j,其余全部初始化成 0;
- 根据
dp[i][j] 的定义,dp[i][0] 表示 word1 中需要删除 i 次变为空字符串与 word2 相同。
- 同理,
dp[0][j] 表示 word2 中需要删除 j 次变为空字符串与 word1 相同。
- 确定遍历顺序:在
i 上正序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。

class Solution {
public:
    int minDistance(string word1, string word2) {
        vector<vector<int>> dp(word1.size()+1, vector<int>(word2.size()+1, 0));
        // 初始化
        for(int i=0; i<=word1.size(); i++)
            dp[i][0] = i;
        for(int j=0; j<=word2.size(); j++)
            dp[0][j] = j;
        // 递推公式
        for(int i=1; i<=word1.size(); i++){
            for(int j=1; j<=word2.size(); j++){
                if(word1[i-1] == word2[j-1])
                    dp[i][j] = dp[i-1][j-1];
                else
                    dp[i][j] = min(dp[i-1][j], dp[i][j-1])+1;
            }
        }
        return dp[word1.size()][word2.size()];
    }
};
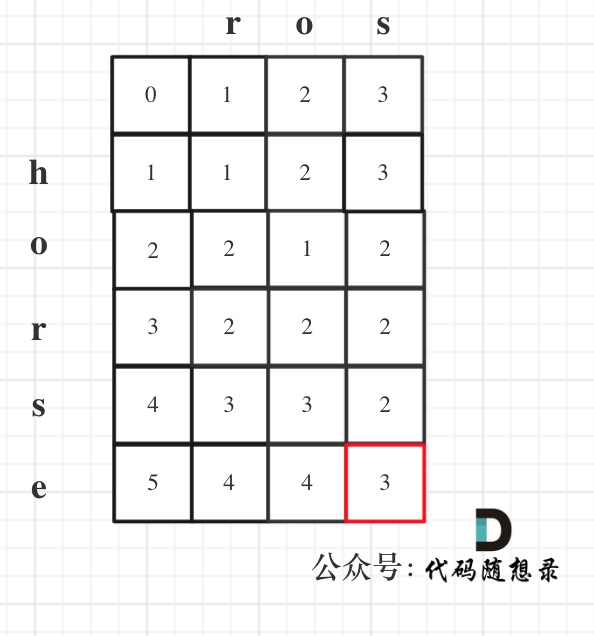
- 编辑距离:72.编辑距离
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][j] 表示以 word1[i-1] 为结尾的字符串 word1,和以 word2[j-1] 结尾的字符串 word2,想要达到相等,所需要进行三种操作的最少次数。
- 确定递推公式:
- 当
word1[i-1] == word2[j-1] 的时候,dp[i][j] = dp[i-1][j-1];,可以理解为是将 word1[i-1] 和 word2[j-1] 删除后使得两个字符串相等的最少次数。
- 否则,
min(dp[i-1][j-1], min(dp[i-1][j], dp[i][j-1]))+1;,可以理解为前一个状态 dp[i-1][j] 或者 dp[i][j-1] 的更小者需要通过 dp[i][j] 的一次删除、增加或者替换操作完成。
dp 数组如何初始化:dp[i][0] 初始化为 i,dp[0][j] 初始化为 j,其余全部初始化成 0;
- 根据
dp[i][j] 的定义,dp[i][0] 表示 word1 中需要删除 i 次变为空字符串与 word2 相同。
- 同理,
dp[0][j] 表示 word2 中需要删除 j 次变为空字符串与 word1 相同。
- 确定遍历顺序:在
i 上正序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。

class Solution {
public:
    int minDistance(string word1, string word2) {
        vector<vector<int>> dp(word1.size()+1, vector<int>(word2.size()+1, 0));
        // 初始化
        for(int i=0; i<=word1.size(); i++)
            dp[i][0] = i;
        for(int j=0; j<=word2.size(); j++)
            dp[0][j] = j;
        for(int i=1; i<=word1.size(); i++){
            for(int j=1; j<=word2.size(); j++){
                if(word1[i-1] == word2[j-1])
                    dp[i][j] = dp[i-1][j-1];
                else
                    dp[i][j] = min(dp[i-1][j-1], min(dp[i-1][j], dp[i][j-1]))+1;
            }
        }
        return dp[word1.size()][word2.size()];
    }
};
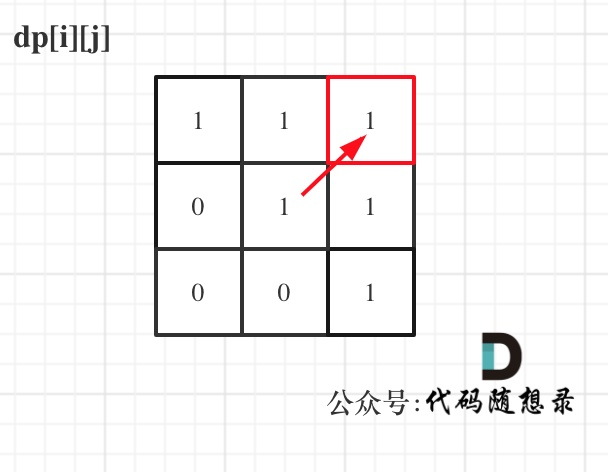
- 回文子串:647.回文子串
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][j] 表示字符串在 [i, j] 的子串是否为回文串。
- 确定递推公式:
- 当
s[i] == s[j] 的时候:
- 如果
j-i<=1,表示 a 或者 aa 一定是回文串,因此 dp[i][j] = true; 。
- 如果
dp[i+1][j-1] == true,表示加上两个相等的元素后的子串也一定是回文串,因此 dp[i][j] = true; 。
- 其他情况都是
false。
dp 数组如何初始化:全部初始化成 false。- 确定遍历顺序:在
i 上倒序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。

class Solution {
public:
    int countSubstrings(string s) {
        vector<vector<bool>> dp(s.size(), vector<bool>(s.size(), false));
        int result = 0;
        for(int i=s.size()-1; i>=0; i--){
            for(int j=i; j<s.size(); j++){
                if(s[i] == s[j]){
                    if(j-i<=1){ // a 或者 aa 一定是回文串
                        dp[i][j] = true;
                        result++;
                    }
                    else if(dp[i+1][j-1] == true){
                        dp[i][j] = true;
                        result++;
                    }
                }
            }
        }
        return result;
    }
};
- 最长回文子序列:516.最长回文子序列
- 思路:
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][j] 表示字符串在 [i, j] 的区间内的最长回文子序列长度。
- 确定递推公式:
- 当
s[i] == s[j] 的时候,表示上一个最长回文子序列的长度再加上两个相等的字符,因此 dp[i][j] = dp[i+1][j-1]+2; 。
- 当
s[i] != s[j] 的时候,选择取出 s[i] 或者 s[j] 元素中的较大回文子序列长度。
dp 数组如何初始化:在 i==j 的部分初始化成 1(i==j 表示至少回文子序列长度为 1),其余初始化成 0。- 确定遍历顺序:在
i 上倒序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。

class Solution {
public:
    int longestPalindromeSubseq(string s) {
        vector<vector<int>> dp(s.size(), vector<int>(s.size(), 0));
        // 初始化 i==j 的部分初始化成 1
        for(int i=0; i<s.size(); i++){
            dp[i][i] = 1;
        }
        for(int i=s.size()-1; i>=0; i--){
            for(int j=i+1; j<s.size(); j++){ // 注意 j=i+1 ,避免覆盖掉初始化值
                if(s[i] == s[j]){
                    dp[i][j] = dp[i+1][j-1]+2;
                }else{
                    dp[i][j] = max(dp[i][j-1], dp[i+1][j]);
                }
            }
        }
        return dp[0][s.size()-1];
    }
};
- 最长回文子串:5.最长回文子串
- 思路:
- 这道题目和回文子串的题目基本一致,只需要加上一个数组记录
i 和 j 之间的最长间距以及各自的值即可,后续将其拼接到数组中。
- 按照动态规划五部曲进行分析:
- 确定
dp 数组及下标的含义:dp[i][j] 表示字符串在 [i, j] 的子串是否为回文串。
- 确定递推公式:
- 当
s[i] == s[j] 的时候:
- 如果
j-i<=1,表示 a 或者 aa 一定是回文串,因此 dp[i][j] = true; 。
- 如果
dp[i+1][j-1] == true,表示加上两个相等的元素后的子串也一定是回文串,因此 dp[i][j] = true; 。
- 其他情况都是
false。
dp 数组如何初始化:全部初始化成 false。- 确定遍历顺序:在
i 上倒序遍历,在 j 上正序遍历;
- 举例推导
dp 数组符合要求。
- 代码:
class Solution {
public:
    string longestPalindrome(string s) {
        vector<vector<bool>> dp(s.size(), vector<bool>(s.size(), false));
        vector<int> ans(3, 0);
        for(int i=s.size()-1; i>=0; i--){
            for(int j=i; j<s.size(); j++){
                if(s[i] == s[j]){
                    if(j-i<=1){ // a 或者 aa 一定是回文串
                        dp[i][j] = true;
                        if(j-i>ans[0]){
                            ans[0] = j-i;
                            ans[1] = i;
                            ans[2] = j;
                        }
                    }
                    else if(dp[i+1][j-1] == true){
                        dp[i][j] = true;
                        if(j-i>ans[0]){
                            ans[0] = j-i;
                            ans[1] = i;
                            ans[2] = j;
                        }
                    }
                }
            }
        }
        string result = "";
        for(int i=ans[1]; i<=ans[2]; i++){
            result+=s[i];
        }
        return result;
    }
};
- 每日温度:739.每日温度
- 思路:
-
通常是一维数组,要寻找任一个元素的右边或者左边第一个比自己大或者小的元素的位置,此时我们就要想到可以用单调栈了。时间复杂度为 $O (n)$。
-
单调栈的本质是空间换时间,因为在遍历的过程中需要用一个栈来记录右边第一个比当前元素高的元素,优点是整个数组只需要遍历一次。更直白来说,就是用一个栈来记录我们遍历过的元素,因为我们遍历数组的时候,我们不知道之前都遍历了哪些元素,以至于遍历一个元素找不到是不是之前遍历过一个更小的,所以我们需要用一个容器(这里用单调栈)来记录我们遍历过的元素。
- 情况一:当前遍历的元素
temperatures[i]<=temperatures[st.top()] 的情况,就将元素的下标 i 加入到栈中( st.push(i); )。
- 情况二:当前遍历的元素
temperatures[i]>temperatures[st.top()] 的情况,要将该元素与栈中的所有小于该元素的数据进行比较,满足则将结果添加的 result 数组中( result[st.top()] = i-st.top(); ),并弹出栈顶元素,最后记得将该元素的下标 i 加入到栈中( st.push(i); )。
- 代码:
class Solution {
public:
    vector<int> dailyTemperatures(vector<int>& temperatures) {
        vector<int> result(temperatures.size(), 0);
        stack<int> st; // 存放下标
        st.push(0);
        for(int i=1; i<temperatures.size(); i++){
            if(temperatures[i]<=temperatures[st.top()]){
                st.push(i);
            }
            else{
                while(!st.empty() && temperatures[i]>temperatures[st.top()]){
                    result[st.top()] = i-st.top();
                    st.pop();
                }
                st.push(i);
            }
        }
        return result;
    }
};
- 下一个更大元素 I:496.下一个更大元素 I
- 思路:
- 这道题目本质上与上一道题目类似,但需要注意的是
nums1 是 nums2 的子集,可以使用 unordered_map<int, int> umap; 的 KV 存储,其中 Key 记录 nums1 下标的元素,Value 记录 nums1 的下标。
- 因为
nums1 是 nums2 的子集,只需要对 nums2 进行遍历即可:
- 情况一:当前遍历的元素
nums2[i] <= nums2[st.top()] 的情况,就将元素的下标 i 加入到栈中( st.push(i); )。
- 情况二:当前遍历的元素
nums2[i] > nums2[st.top()] 的情况,通过 umap.count(nums2[st.top()])>0 判断栈顶的元素是否在 nums1 数组中:
- 如果栈顶元素属于
nums1 数组,则取出该元素在 nums1 中的下标 index,将结果记录 result[index] = nums2[i];,并弹出栈顶元素,最后记得将该元素的下标 i 加入到栈中( st.push(i); )。
- 代码:
class Solution {
public:
    vector<int> nextGreaterElement(vector<int>& nums1, vector<int>& nums2) {
        vector<int> result(nums1.size(), -1);
        if(nums1.size() == 0)
            return result;
        unordered_map<int, int> umap; // key: nums1下标的元素,value:nums1的下标
        for(int i=0; i<nums1.size();i++){
            umap[nums1[i]] = i;
        }
        stack<int> st;
        st.push(0);
        for(int i=1; i<nums2.size(); i++){
            if(nums2[i] <= nums2[st.top()]){
                st.push(i);
            }
            else{
                while(!st.empty() && nums2[i] > nums2[st.top()]){
                    if(umap.count(nums2[st.top()])>0){ // 需要注意 nums1 是 nums2 的子集
                        int index = umap[nums2[st.top()]];
                        result[index] = nums2[i];
                    }
                    st.pop();
                }
                st.push(i);
            }
        }
        return result;
    }
};
- 下一个更大元素 II:503.下一个更大元素 II
- 思路:
- 这道题目和每日温度基本一致,关键在于处理循环数组,循环数组的处理可以通过遍历的长度变为原来的两倍
nums.size()*2 ,然后循环体内的 i 变为取余处理( i%nums.size() )即可解决。
- 代码:
class Solution {
public:
    vector<int> nextGreaterElements(vector<int>& nums) {
        vector<int> result(nums.size(), -1);
        stack<int> st; // 存放下标
        st.push(0);
        for(int i=1; i<nums.size()*2; i++){
            if(nums[i%nums.size()]<=nums[st.top()]){
                st.push(i%nums.size());
            }
            else{
                while(!st.empty() && nums[i%nums.size()]>nums[st.top()]){
                    result[st.top()] = nums[i%nums.size()];
                    st.pop();
                }
                st.push(i%nums.size());
            }
        }
        return result;
    }
};
- 接雨水:42.接雨水
- 思路:
- 这道题目采用单调递增栈来进行处理:
- 情况一:当前遍历的元素
height[i] < height[st.top()] 的情况,就将元素的下标 i 加入到栈中( st.push(i); )。
- 情况二:当前遍历的元素
height[i] == height[st.top()] 的情况,先将栈顶元素弹出,再将元素的下标 i 加入到栈中( st.push(i); )。
- 情况三:当前遍历的元素
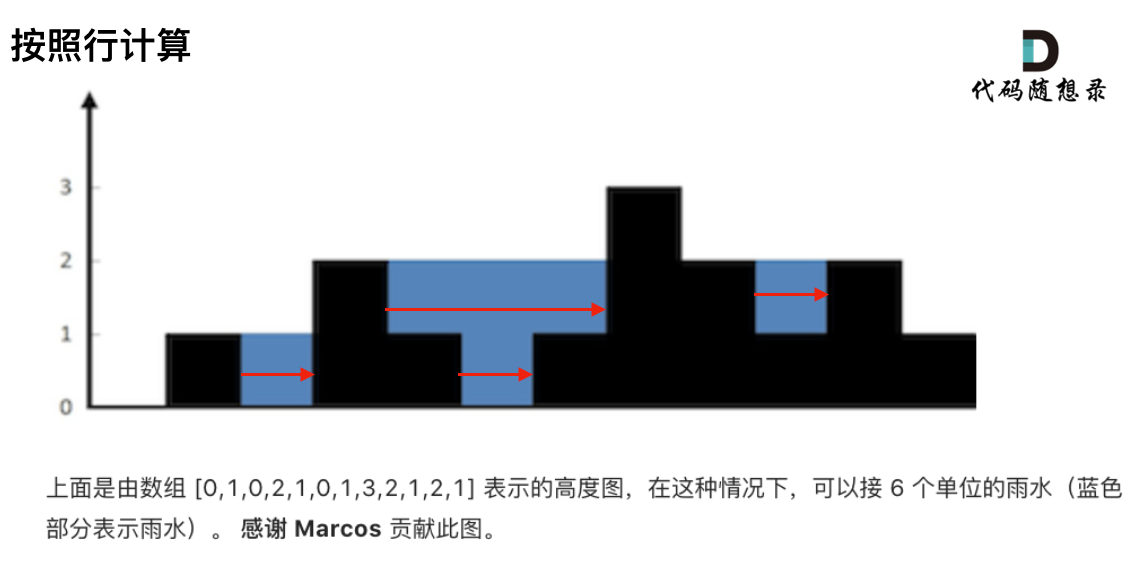
height[i] > height[st.top()] 的情况,记录栈顶元素作为中间节点 mid( int mid = st.top(); ),再将栈顶元素弹出( st.pop(); ),因为是单调递增栈,此时有 height[mid] < height[st.top()] 以及 height[mid] < height[i] 这两个关系,就能够按照行的方式计算它们之间的收集雨水面积。

class Solution {
public:
    int trap(vector<int>& height) {
        if(height.size() == 0)
            return 0;
        int ans = 0;
        stack<int> st;
        st.push(0);
        for(int i=1; i<height.size(); i++){
            if(height[i]<height[st.top()])
                st.push(i);
            else if(height[i] == height[st.top()]){
                st.pop();
                st.push(i);
            }
            else{
                while(!st.empty() && height[i]>height[st.top()]){
                    int mid = st.top();
                    st.pop();
                    if(!st.empty()){
                        int h = min(height[i], height[st.top()])-height[mid];
                        int w = i-st.top()-1;
                        ans+=h*w;
                    }
                }
                st.push(i);
            }
        }
        return ans;
    }
};
- 柱状图中最大的矩形:84.柱状图中最大的矩形
- 思路:
- 这道题目整体上和上一题类似,但是要在数组的首位插入元素
0,要采用单调递减栈来进行处理:
- 情况一:当前遍历的元素
heights[i] > heights[st.top()] 的情况,就将元素的下标 i 加入到栈中( st.push(i); )。
- 情况二:当前遍历的元素
heights[i] == heights[st.top()] 的情况,现将栈顶元素弹出,再将元素的下标 i 加入到栈中( st.push(i); )。
- 情况三:当前遍历的元素
heights[i] < heights[st.top()] 的情况,记录栈顶元素作为中间节点 mid( int mid = st.top(); ),再将栈顶元素弹出( st.pop(); ),因为是单调递减栈,此时有 heights[mid] > height[st.top()] 以及 height[mid] > height[i] 这两个关系,就能够按照行的方式计算它们之间的最大矩形面积。
class Solution {
public:
    int largestRectangleArea(vector<int>& heights) {
        if(heights.size() == 1)
            return heights[0];
        int ans = 0;
        // 数组前后加 0
        heights.insert(heights.begin(), 0);
        heights.push_back(0);
        stack<int> st;
        st.push(0);
        // 单调递减栈
        for(int i=1; i<heights.size(); i++){
            if(heights[i] > heights[st.top()])
                st.push(i);
            else if(heights[i] == heights[st.top()]){
                st.pop();
                st.push(i);
            }else{
                while(!st.empty() && heights[i] < heights[st.top()]){
                    int mid = st.top();
                    st.pop();
                    if(!st.empty()){
                        int h = heights[mid];
                        int w = i-st.top()-1;
                        ans = max(ans, h*w);
                    }
                }
                st.push(i);
            }
        }
        return ans;
    }
};
- 岛屿数量:200.岛屿数量
- 思路:
-
- 遍历整个矩阵
- 从
(0,0) 开始,逐个格子扫描。
- 当遇到
graph[i][j] == 1 且未访问过时,说明发现了一个新的岛屿。
-
- 启动 DFS/BFS 搜索
- 从当前点
(i, j) 出发,用 DFS 或 BFS 遍历它的上下左右相邻的格子。
- 把所有与它连通的
1 都标记为已访问,避免重复计数。
- 遍历的方向一般用数组
dir[4][2] = {{0,1},{1,0},{0,-1},{-1,0}} 来表示四个方向。
-
- 计数
- 每次发现一个新的起点(未访问的
1),结果 result++。
- 搜索完成后,这整块连通区域就不会再被重复计算。
-
- 边界条件
- 判断
x, y 是否越界。
- 避免访问
0 或已经访问过的格子。
- 代码(深度优先搜索):
class Solution {
public:

    // 代表上下左右四个方向
    const int dir[4][2] = {0,1,1,0,0,-1,-1,0};

    void dfs(vector<vector<char>>& graph, vector<vector<bool>>& visited, int x, int y){
        // 终止条件
        if(graph[x][y] == '0' || visited[x][y])
            return;
        visited[x][y] = true;
        for(int i=0; i<4; i++){
            int nextx = x + dir[i][0];
            int nexty = y + dir[i][1];
            if(nextx<0 || nextx>=graph.size() || nexty<0 || nexty>=graph[0].size())
	            continue;
            dfs(graph, visited, nextx, nexty);
        }
    }

    int numIslands(vector<vector<char>>& grid) {
        vector<vector<bool>> visited(grid.size(), vector<bool>(grid[0].size(), false));
        int result = 0;
        for(int i=0; i<grid.size(); i++){
            for(int j=0; j<grid[0].size(); j++){
                if(grid[i][j] == '1' && !visited[i][j]){
                    result++;
                    dfs(grid, visited, i, j);
                }
            }
        }
        return result;
    }
};#include <bits/stdc++.h>
using namespace std;
// 代表上下左右四个方向
const int dir[4][2] = {0,1,1,0,0,-1,-1,0};
void dfs(vector<vector<int>>& graph, vector<vector<bool>>& visited, int x, int y){
// 终止条件
if(graph[x][y] == 0 || visited[x][y])
return;
visited[x][y] = true;
for(int i=0; i<4; i++){
int nextx = x + dir[i][0];
int nexty = y + dir[i][1];
if(nextx<0 || nextx>=graph.size() || nexty<0 || nexty>=graph[0].size())
continue;
dfs(graph, visited, nextx, nexty);
}
}
int main() {
int m, n;
scanf("%d %d", &m, &n);
vector<vector<int>> graph(m, vector<int>(n, 0));
vector<vector<bool>> visited(m, vector<bool>(n, false));
for(int i=0; i<m; i++){
for(int j=0; j<n; j++){
scanf("%d", &graph[i][j]);
// printf("%d ", graph[i][j]);
}
// printf("\n");
}
int result = 0;
for(int i=0; i<m; i++){
for(int j=0; j<n; j++){
if(graph[i][j] == 1 && !visited[i][j]){
result++;
dfs(graph, visited, i, j);
}
}
}
printf("%d\n", result);
return 0;
}#include <bits/stdc++.h>
using namespace std;
// 代表上下左右四个方向
const int dir[4][2] = {0,1,1,0,0,-1,-1,0};
// 广搜
void bfs(vector<vector<int>>& graph, vector<vector<bool>>& visited, int x, int y){
queue<pair<int, int>> que;
que.push({x, y});
visited[x][y] = true; // 入队列就标记为访问过
while(!que.empty()){
pair<int, int> cur = que.front();
que.pop();
for(int i=0; i<4; i++){
int nextx = cur.first + dir[i][0];
int nexty = cur.second + dir[i][1];
if(nextx<0 || nextx>=graph.size() || nexty<0 || nexty>=graph[0].size())
continue;
if (!visited[nextx][nexty] && graph[nextx][nexty] == 1) {
que.push({nextx, nexty});
visited[nextx][nexty] = true; // 入队列就标记为访问过
}
}
}
}
int main() {
int m, n;
scanf("%d %d", &m, &n);
vector<vector<int>> graph(m, vector<int>(n, 0));
vector<vector<bool>> visited(m, vector<bool>(n, false));
for(int i=0; i<m; i++){
for(int j=0; j<n; j++){
scanf("%d", &graph[i][j]);
// printf("%d ", graph[i][j]);
}
// printf("\n");
}
int result = 0;
for(int i=0; i<m; i++){
for(int j=0; j<n; j++){
if(graph[i][j] == 1 && !visited[i][j]){
result++;
bfs(graph, visited, i, j);
}
}
}
printf("%d\n", result);
return 0;
}
- 岛屿的最大面积:105.岛屿的最大面积
- 思路:
-
- 遍历整个矩阵
- 从
(0,0) 开始,逐个格子扫描。
- 当遇到
graph[i][j] == 1 且未访问过时,说明发现了一个新的岛屿。
-
- 启动 DFS/BFS 搜索
- 从当前点
(i, j) 出发,用 DFS 或 BFS 遍历它的上下左右相邻的格子。
- 把所有与它连通的
1 都标记为已访问,避免重复计数,并且将 1 的数量加到 count 中。
- 遍历的方向一般用数组
dir[4][2] = {{0,1},{1,0},{0,-1},{-1,0}} 来表示四个方向。
-
- 计数
- 每次发现一个新的起点(未访问的
1),标记 count = 0 ,从当前点 (i, j) 出发,用 DFS 或 BFS 遍历它的上下左右相邻的格子,并且将 1 的数量加到 count 中。最后和 result 比较取最大值:result = max(result, count); 。
- 搜索完成后,这整块连通区域就不会再被重复计算。
-
- 边界条件
- 判断
x, y 是否越界。
- 避免访问
0 或已经访问过的格子。
- 代码:
class Solution {
public:
    // 代表上下左右四个方向
    const int dir[4][2] = {0,1,1,0,0,-1,-1,0};

    void dfs(vector<vector<int>>& graph, vector<vector<bool>>& visited, int& count, int x, int y){
        // 终止条件
        if(graph[x][y] == 0 || visited[x][y])
            return;
        count++;
        visited[x][y] = true;
        for(int i=0; i<4; i++){
            int nextx = x + dir[i][0];
            int nexty = y + dir[i][1];
            if(nextx<0 || nextx>=graph.size() || nexty<0 || nexty>=graph[0].size())
            continue;
            dfs(graph, visited, count, nextx, nexty);
        }
    }

    int maxAreaOfIsland(vector<vector<int>>& grid) {
        int count = 0;
        int result = 0;
        vector<vector<bool>> visited(grid.size(), vector<bool>(grid[0].size(), false));
        for(int i=0; i<grid.size(); i++){
            for(int j=0; j<grid[0].size(); j++){
                count = 0;
                dfs(grid, visited, count, i, j);
                result = max(result, count);
            }
        }
        return result;
    }
};#include <bits/stdc++.h>
using namespace std;
// 代表上下左右四个方向
const int dir[4][2] = {0,1,1,0,0,-1,-1,0};
void dfs(vector<vector<int>>& graph, vector<vector<bool>>& visited, int& count, int x, int y){
// 终止条件
if(graph[x][y] == 0 || visited[x][y])
return;
count++;
visited[x][y] = true;
for(int i=0; i<4; i++){
int nextx = x + dir[i][0];
int nexty = y + dir[i][1];
if(nextx<0 || nextx>=graph.size() || nexty<0 || nexty>=graph[0].size())
continue;
dfs(graph, visited, count, nextx, nexty);
}
}
int main() {
int m, n;
scanf("%d %d", &m, &n);
vector<vector<int>> graph(m, vector<int>(n, 0));
vector<vector<bool>> visited(m, vector<bool>(n, false));
for(int i=0; i<m; i++){
for(int j=0; j<n; j++){
scanf("%d", &graph[i][j]);
// printf("%d ", graph[i][j]);
}
// printf("\n");
}
int result = 0;
// 记录岛屿最大面积
int count = 0;
for(int i=0; i<m; i++){
for(int j=0; j<n; j++){
if(graph[i][j] == 1 && !visited[i][j]){
count = 0;
dfs(graph, visited, count, i, j);
result = max(result, count);
}
}
}
printf("%d\n", result);
return 0;
}
- 孤岛的总面积:101.孤岛的总面积
- 思路:
-
- 遍历矩阵的边
- 遍历矩阵的四个边。
- 当遇到
graph[i][j] == 1 时,说明发现了一个新的不是孤岛的岛屿。
-
- 启动 DFS/BFS 搜索
- 从当前点
(i, j) 出发,用 DFS 或 BFS 遍历它的上下左右相邻的格子。
- 把所有与它连通的
1 都标记为 0 ,避免重复计数。
- 遍历的方向一般用数组
dir[4][2] = {{0,1},{1,0},{0,-1},{-1,0}} 来表示四个方向。
-
- 计数
- 四条边搜索完成后,把和陆地相连的岛屿全部变成
0,剩下的全部是孤岛,只需要再遍历一次 graph 把 1 的数量统计出来就是孤岛的面积了。
-
- 边界条件
- 判断
x, y 是否越界。
- 避免访问
0 或已经访问过的格子。
- 代码:
#include <bits/stdc++.h>

using namespace std;

// 代表上下左右四个方向
const int dir[4][2] = {0,1,1,0,0,-1,-1,0};

void dfs(vector<vector<int>>& graph, int x, int y){
    // 终止条件
    if(graph[x][y] == 0)
        return;
    graph[x][y] = 0;
    for(int i=0; i<4; i++){
        int nextx = x + dir[i][0];
        int nexty = y + dir[i][1];
        if(nextx<0 || nextx>=graph.size() || nexty<0 || nexty>=graph[0].size())
            continue;
        dfs(graph, nextx, nexty);
    }
}

int main() {
    int m, n;
    scanf("%d %d", &m, &n);
    vector<vector<int>> graph(m, vector<int>(n, 0));
    vector<vector<bool>> visited(m, vector<bool>(n, false));
    for(int i=0; i<m; i++){
        for(int j=0; j<n; j++){
            scanf("%d", &graph[i][j]);
        }
    }
    // 代码逻辑部分
    for(int i=0; i<m; i++){
        if(graph[i][0] == 1)
            dfs(graph, i, 0);
        if(graph[i][n-1] == 1)
            dfs(graph, i, n-1);
    }
    for(int i=0; i<n; i++){
        if(graph[0][i] == 1)
            dfs(graph, 0, i);
        if(graph[m-1][i] == 1)
            dfs(graph, m-1, i);
    }
    int result = 0;
    for(int i=0; i<m; i++){
        for(int j=0; j<n; j++){
            if(graph[i][j] == 1){
                result++;
            }
        }
    }
    printf("%d\n", result);
    return 0;
}
- 沉没孤岛:102.沉没孤岛
- 思路:
-
- 遍历矩阵的边
- 遍历矩阵的四个边。
- 当遇到
graph[i][j] == 1 时,说明发现了一个新的不是孤岛的岛屿。
-
- 启动 DFS/BFS 搜索
- 从当前点
(i, j) 出发,用 DFS 或 BFS 遍历它的上下左右相邻的格子。
- 把所有与它连通的
1 都标记为 0 ,避免重复计数。
- 遍历的方向一般用数组
dir[4][2] = {{0,1},{1,0},{0,-1},{-1,0}} 来表示四个方向。
-
- 计数
- 四条边搜索完成后,把和陆地相连的岛屿全部变成
0,剩下的全部是孤岛,只需要在输出的时候把遍历到的 1 变成 0 即可。
-
- 边界条件
- 判断
x, y 是否越界。
- 避免访问
0 或已经访问过的格子。
- 代码:
#include <bits/stdc++.h>

using namespace std;

const int dir[4][2] = {{0, 1}, {1, 0}, {-1, 0}, {0, -1}};

void dfs(vector<vector<int>>& graph, int x, int y) {
  if (graph[x][y] == 0)
    return;
  graph[x][y] = 0;
  for (int i = 0; i < 4; i++) {
    int nextx = x + dir[i][0];
    int nexty = y + dir[i][1];
    if (nextx < 0 || nextx >= graph.size() || nexty < 0 ||
        nexty >= graph[0].size())
      continue;
    dfs(graph, nextx, nexty);
  }
}

int main(){
    // 读入数据
    int m,n;
    scanf("%d %d",&m, &n);
    int num;
    vector<vector<int>> graph(m, vector<int>(n, 0));
    vector<vector<int>> ans(m, vector<int>(n, 0));
    for(int i=0; i<m; i++){
        for(int j=0; j<n; j++){
            scanf("%d", &num);
            graph[i][j] = num;
            ans[i][j] = num;
        }
    }

    // 数据处理
    for(int i=0; i<m; i++){
        if(graph[i][0] == 1)
            dfs(graph, i, 0);
        if(graph[i][n-1] == 1)
            dfs(graph, i, n-1);
    }

    for(int i=0; i<n; i++){
        if(graph[0][i] == 1)
            dfs(graph, 0, i);
        if(graph[m-1][i] == 1)
            dfs(graph, m-1, i);
    }

    // 组装并输出答案
    for(int i=0; i<m; i++){
        for(int j=0; j<n; j++){
            if(graph[i][j] == 1)
                ans[i][j] = 0;
            printf("%d ", ans[i][j]);
        }
        printf("\n");
    }

    return 0;
}
- 高山流水:103.高山流水
- 思路:
+ 这题的关键不是从每个点正向判断能流到哪里。
- 而是 从两组边界反向 DFS,分别标记所有能够流到这两组边界的位置。
- 最后同时被
first 和 second 标记到的位置,就是答案。
- 代码:
#include <bits/stdc++.h>
using namespace std;

const int dir[4][2] = {{0,1}, {1,0}, {-1,0}, {0,-1}};

void dfs(vector<vector<int>>& graph, int x, int y, vector<vector<bool>>& visited){
    if(visited[x][y])
        return;
    visited[x][y] = true;
    for(int i=0; i<4; i++){
        int nextx = x + dir[i][0];
        int nexty = y + dir[i][1];
        if(nextx<0 || nextx>=graph.size() || nexty<0 || nexty>=graph[0].size())
            continue;
        if(graph[nextx][nexty] >= graph[x][y])
            dfs(graph, nextx, nexty, visited);
    }
}

int main(){
    int m, n;
    scanf("%d %d", &m, &n);
    vector<vector<int>> graph(m, vector<int>(n, 0));
    int num;
    for(int i=0; i<m; i++){
        for(int j=0; j<n; j++){
            scanf("%d", &num);
            graph[i][j] = num;
        }
    }

    // 从两边出发
    vector<vector<bool>> first(m, vector<bool>(n, false));
    vector<vector<bool>> second(m, vector<bool>(n, false));
    for(int i=0; i<m; i++){
        dfs(graph, i, 0, first);
        dfs(graph, i, n-1, second);
    }
    for(int i=0; i<n; i++){
        dfs(graph, 0, i, first);
        dfs(graph, m-1, i, second);
    }

    for(int i=0; i<m; i++){
        for(int j=0; j<n; j++){
            if(first[i][j] && second[i][j])
                printf("%d %d\n", i, j);
        }
    }

    return 0;
}