本项目为针对高校中国海洋大学的自建搜索引擎,README.md文档待完善
- 从mysql获取urls: 将 MySQL 中存储的待爬取 URL 拉取到 Redis的名称为urls的列表中: Redis 的 LPUSH 或 RPUSH 将 URL 插入 Redis 列表,供爬虫消费。 同时将url加入到all_urls这个set中,防止爬取时重复添加url到mysql中
- 爬取: GetUrlFromRedis:从redis中取出url IsUrlVisited:判断是否已经爬取过如果没有则进行爬取 解析url以及对应爬取的页面,存入数据库,对于页面中出现的url,如果不在redis的名为all_urls的set表中则添加到mysql中,并且添加到set表,如果在set表中则跳过
- 生成倒排索引,将倒排索引添加到redis中
- 定期从redis中随机取出一部分使用事务追加到mysql的对应词的位置
使用BM25算法对搜索词和文章进行相关性排序
在 GORM 中,默认情况下,表名是根据模型结构体的复数形式生成的。 对于 Page 结构体,GORM 会自动将其表名设置为 pageDics 而不是 page。这是因为 GORM 使用了复数化规则来生成表名。
在结构体上使用 gorm:"tableName:page" 标签来显式指定表名,通过覆写 TableName 方法来指定表名:
func (Page) TableName() string {
	return "page"
}使用main.go中的migrate函数将数据库分为256个表,通过在main函数中调用migrate函数来创建表
使用redis创建了两个set,一个叫做visited_urls,另一个叫all_urls,visited_urls用来存储已经访问过的url,all_urls用来存储所有的url visited_urls用来防止之前添加到待爬取list中的url没有被爬取,又被添加到待爬取list中,从而进行重复爬取 all_urls用来防止重复添加和数据库中url重复的url到待爬取list中,确保数据库中存储的url唯一
使用一张大表index存储分词定时迁移到分表index_00到index_ff中
为什么不直接存储到分表中呢? 因为每个分词的值都是由不同的页面共同影响,如果一个页面中的词发生改变,例如删除了一个词,那么这个结果是没有办法反映到分表中的,所以需要一个大表来存储所有的分词,然后定时迁移到分表中
每24小时检测一次redis中的分词个数,如果分词个数小于1000则将分词库中的分词删除,并且将数据库中爬取状态为1的url的分词状态置0 对于为什么是小于1000,而不是在等于零的时候进行分词状态的刷新呢,因为爬取的页面时时刻刻在增加,会造成分词的增加和减少之间的一种平衡,所以设置一个阈值,当分词个数小于1000时,进行刷新,确保更新的及时性
使用定时器进行检测,如果已经分词的页面总数占已经爬取的页面总数的百分比大于0.7,并且分词表中的分词个数小于1000,则替换分词表
CGO_ENABLED=0 GOOS=linux GOARCH=amd64 go build -o oucsearch
BM25 算法是现代搜索引擎的基础,它可以很好地反映一个词和一堆文本的相关性。它拥有不少独特的设计思想,我们下面会详细解释。
这个算法第一次被生产系统使用是在 1980 年代的伦敦城市大学,在一个名为 Okapi 的信息检索系统中被实现出来,而原型算法来自 1970 年代 Stephen E. Robertson、Karen Spärck Jones 和他们的同伴开发的概率检索框架。所以这个算法也叫 Okapi BM25,这里的 BM 代表的是best matching(最佳匹配),非常实在,和比亚迪的“美梦成真”有的一拼(Build Your Dreams)😂
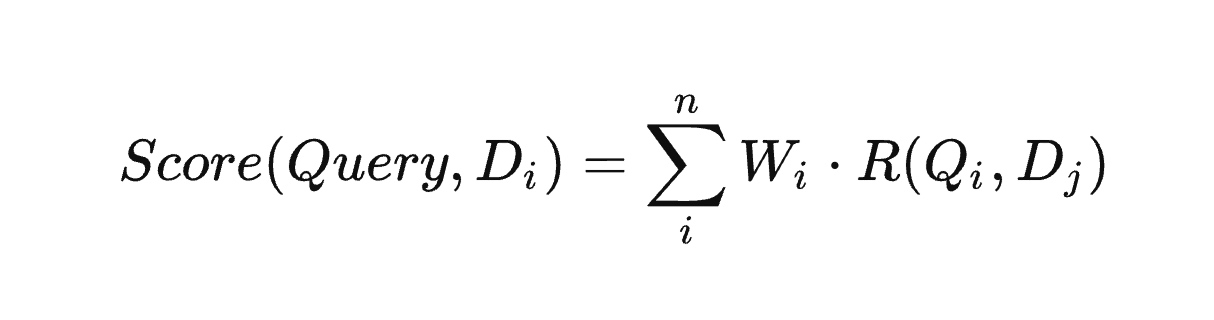
我简单描述一下这个算法的含义。
首先,假设我们有 100 个页面,并且已经对他们分词,并全部生成了倒排索引。此时,我们需要搜索这句话“BM25 算法的数学描述”,我们就需要按照以下步骤来计算:
- 对“BM25 算法的数学描述”进行分词,得到“BM25”、“算法”、“的”、“数学”、“描述”五个词
- 拿出这五个词的全部字典信息,假设包含这五个词的页面一共有 50 个
- 逐个计算这五个词和这 50 个页面的
相关性权重和相关性得分的乘积(当然,不是每个词都出现在了这 50 个网页中,有多少算多少) - 把这 50 页面的分数分别求和,再倒序排列,即可以获得“BM25 算法的数学描述”这句话在这 100 个页面中的搜索结果
相关性权重和相关性得分名字相似,别搞混了,它们的具体定义如下:
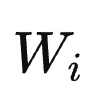
上图中的Wi指代的就是相关性权重,最常用的是TF-IDF算法中的IDF权重计算法:
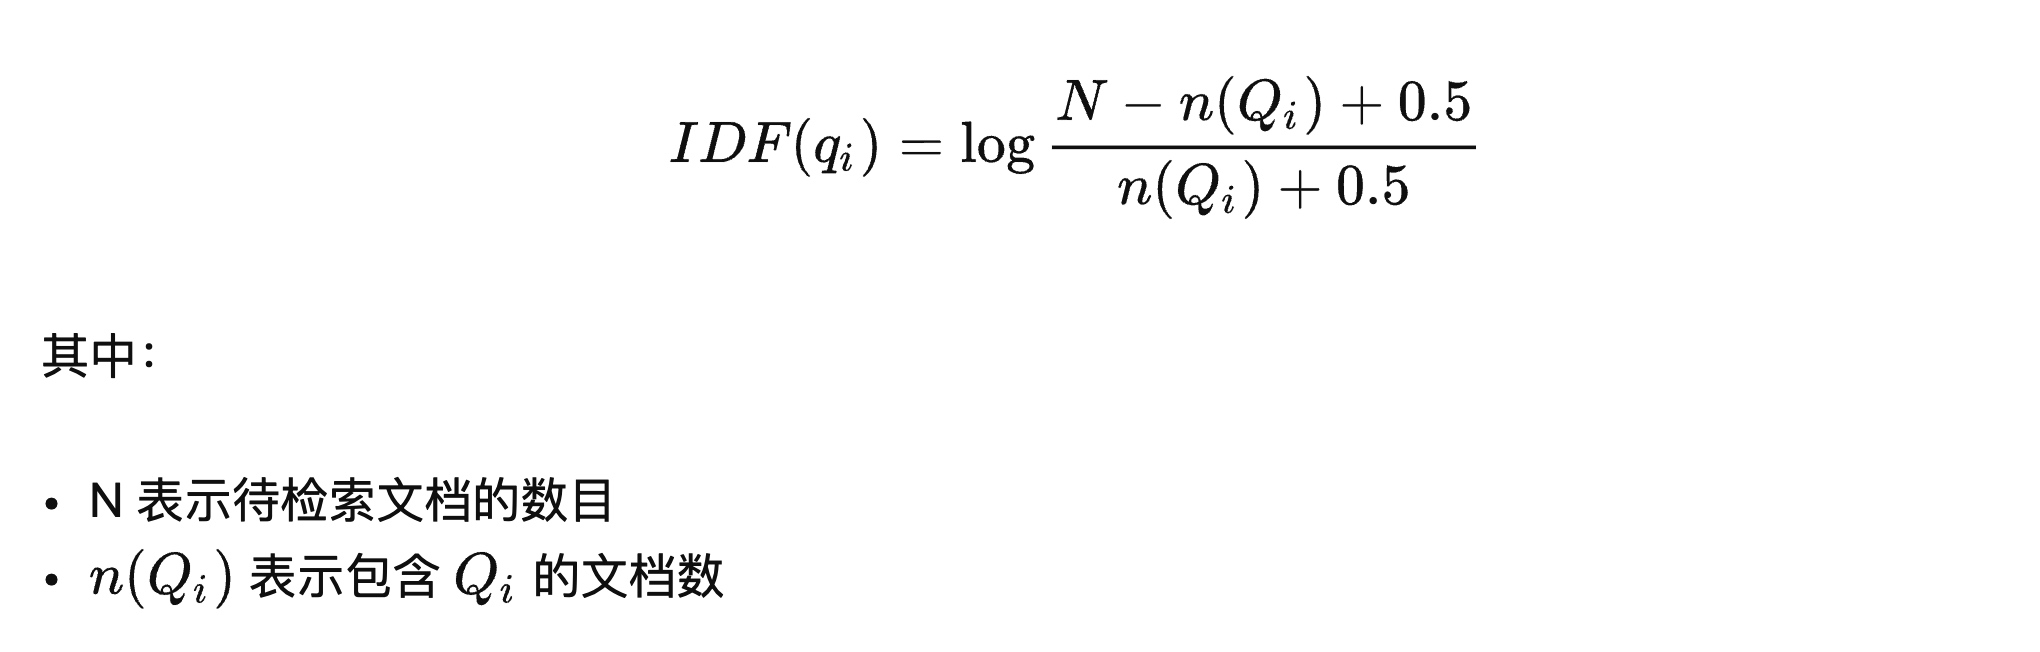
这里的 N 指的是页面总数,就是你已经加入字典的页面数量,需要动态扫描 MySQL 字典,对我来说就是 249 万。而n(Qi)就是这个词的字典长度,就是含有这个词的页面有多少个,就是我们字典值中-出现的次数。
这个参数的现实意义是:如果一个词在很多页面里面都出现了,那说明这个词不重要,例如百分百空手接白刃的“的”字,哪个页面都有,说明这个词不准确,进而它就不重要。
词以稀为贵。

这个表达式看起来是不是很复杂,但是它的复杂度是为了处理查询语句里面某一个关键词出现了多次的情况,例如“八百标兵奔北坡,炮兵并排北边跑。炮兵怕把标兵碰,标兵怕碰炮兵炮。”,“炮兵”这个词出现了 3 次。为了能快速实现一个能用的搜索引擎,我们放弃支持这种情况,然后这个看起来就刺激的表达式就可以简化成下面这种形式:
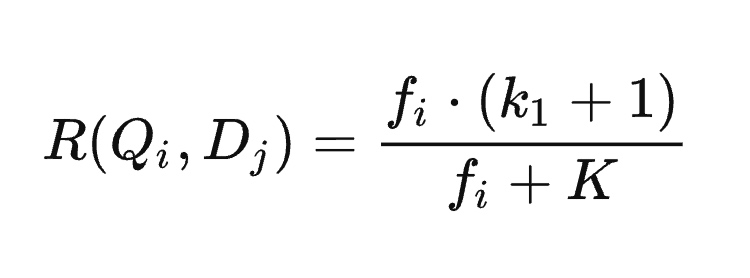
| 功能 | 优势 | 描述 |
|---|---|---|
| 高性能检索 | ✅多索引策略 各 | 支持 HNSW、IVF、PQ 等多种索引类型,能够 快速完成近似最近邻(ANN)搜索,满足高效 检索需求。 |
| 分布式架构 | ✅水平扩展 | 支持分布式存储与计算,轻松扩展至数十亿级别 的数据,适合大规模应用场景。 |
| 实时更新能力 | ✅动态插入、删除、更新 | 数据可以实时更新,适合需要处理流式数据或频 繁变化的数据集的场景。 |
| 支持多模态数据 | ✅适配多种数据类型 | 能够处理文本、图像、音频、视频等多模态数 据,轻松实现跨模态检索。 |
| 元数据管理 | ✅元数据和向量绑定 | 不仅存储高维向量,还支持丰富的元数据管 理,能够在检索时进行元数据过滤,提高查询 灵活性。 |
| 多语言支持 | ✅丰富的 SDK | 提供 Python、Java、Go、C++等多种客户端 SDK,方便开发者快速集成。 |
| 生态系统集成 | ✅与深度学习工具无缝衔接 √ | 可以与 TensorFlow、PyTorch 等深度学习框架 无缝集成,支持在 AI应用中的直接使用。 |
| 高可用性 | ✅支持分片和副本 | 数据分布在多个节点上,支持自动故障恢复,保 障服务稳定性。 |
| 开源和社区支持 | ✅开源免费 | 拥有活跃的开源社区,提供丰富的文档和更新频 率,支持用户定制开发。 |
| 灵活部署 | ✅多部署方式 | 支持本地部署、Kubernetes 分布式部署以及托 管服务(如 Zilliz Cloud),适应不同规模和需 求的场景。 |
| 高效索引构建 | ✅存储与计算分离 | 索引构建高效,且存( 十算分离设计提高了系 ↓ 统的扩展性和可靠性。 |
- 倒排索引
- 分表
- 去重
- 分词
- 修改index方案,改为两个数据库轮换使用
- 频率控制--使用redis
- 页面上添加面试题
- 爬虫超时重试
- 自动切换内网搜索
- pagerank算法
- seo优化
- 循环爬取
- 使用Embedding进行优化,使用向量数据库Milvus进行向量检索
- 解决重复页面问题
- 通过redis加速倒排索引的查询
- 使用布隆过滤器解决url去重问题
export GOPROXY=https://goproxy.cn
函数中调用函数的话defer的执行顺序 协程中调用函数并且传入wg会出问题么,http.client超时之后会发送什么 引用变量声明周期问题