
机器学习/深度学习 理论分析/项目实战
本系列为机器学习/深度学习的整体理论与项目实践总结,均为本人收集资料与个人理解,如有侵权,请联系删除图片或增加引用。本资料适合初步学习机器学习的在校生或准备面试的工程师,主要帮助大家在理论层面了解机器学习,并辅以案例项目帮助理解。欢迎大家访问本人的Github,互相交流学习!
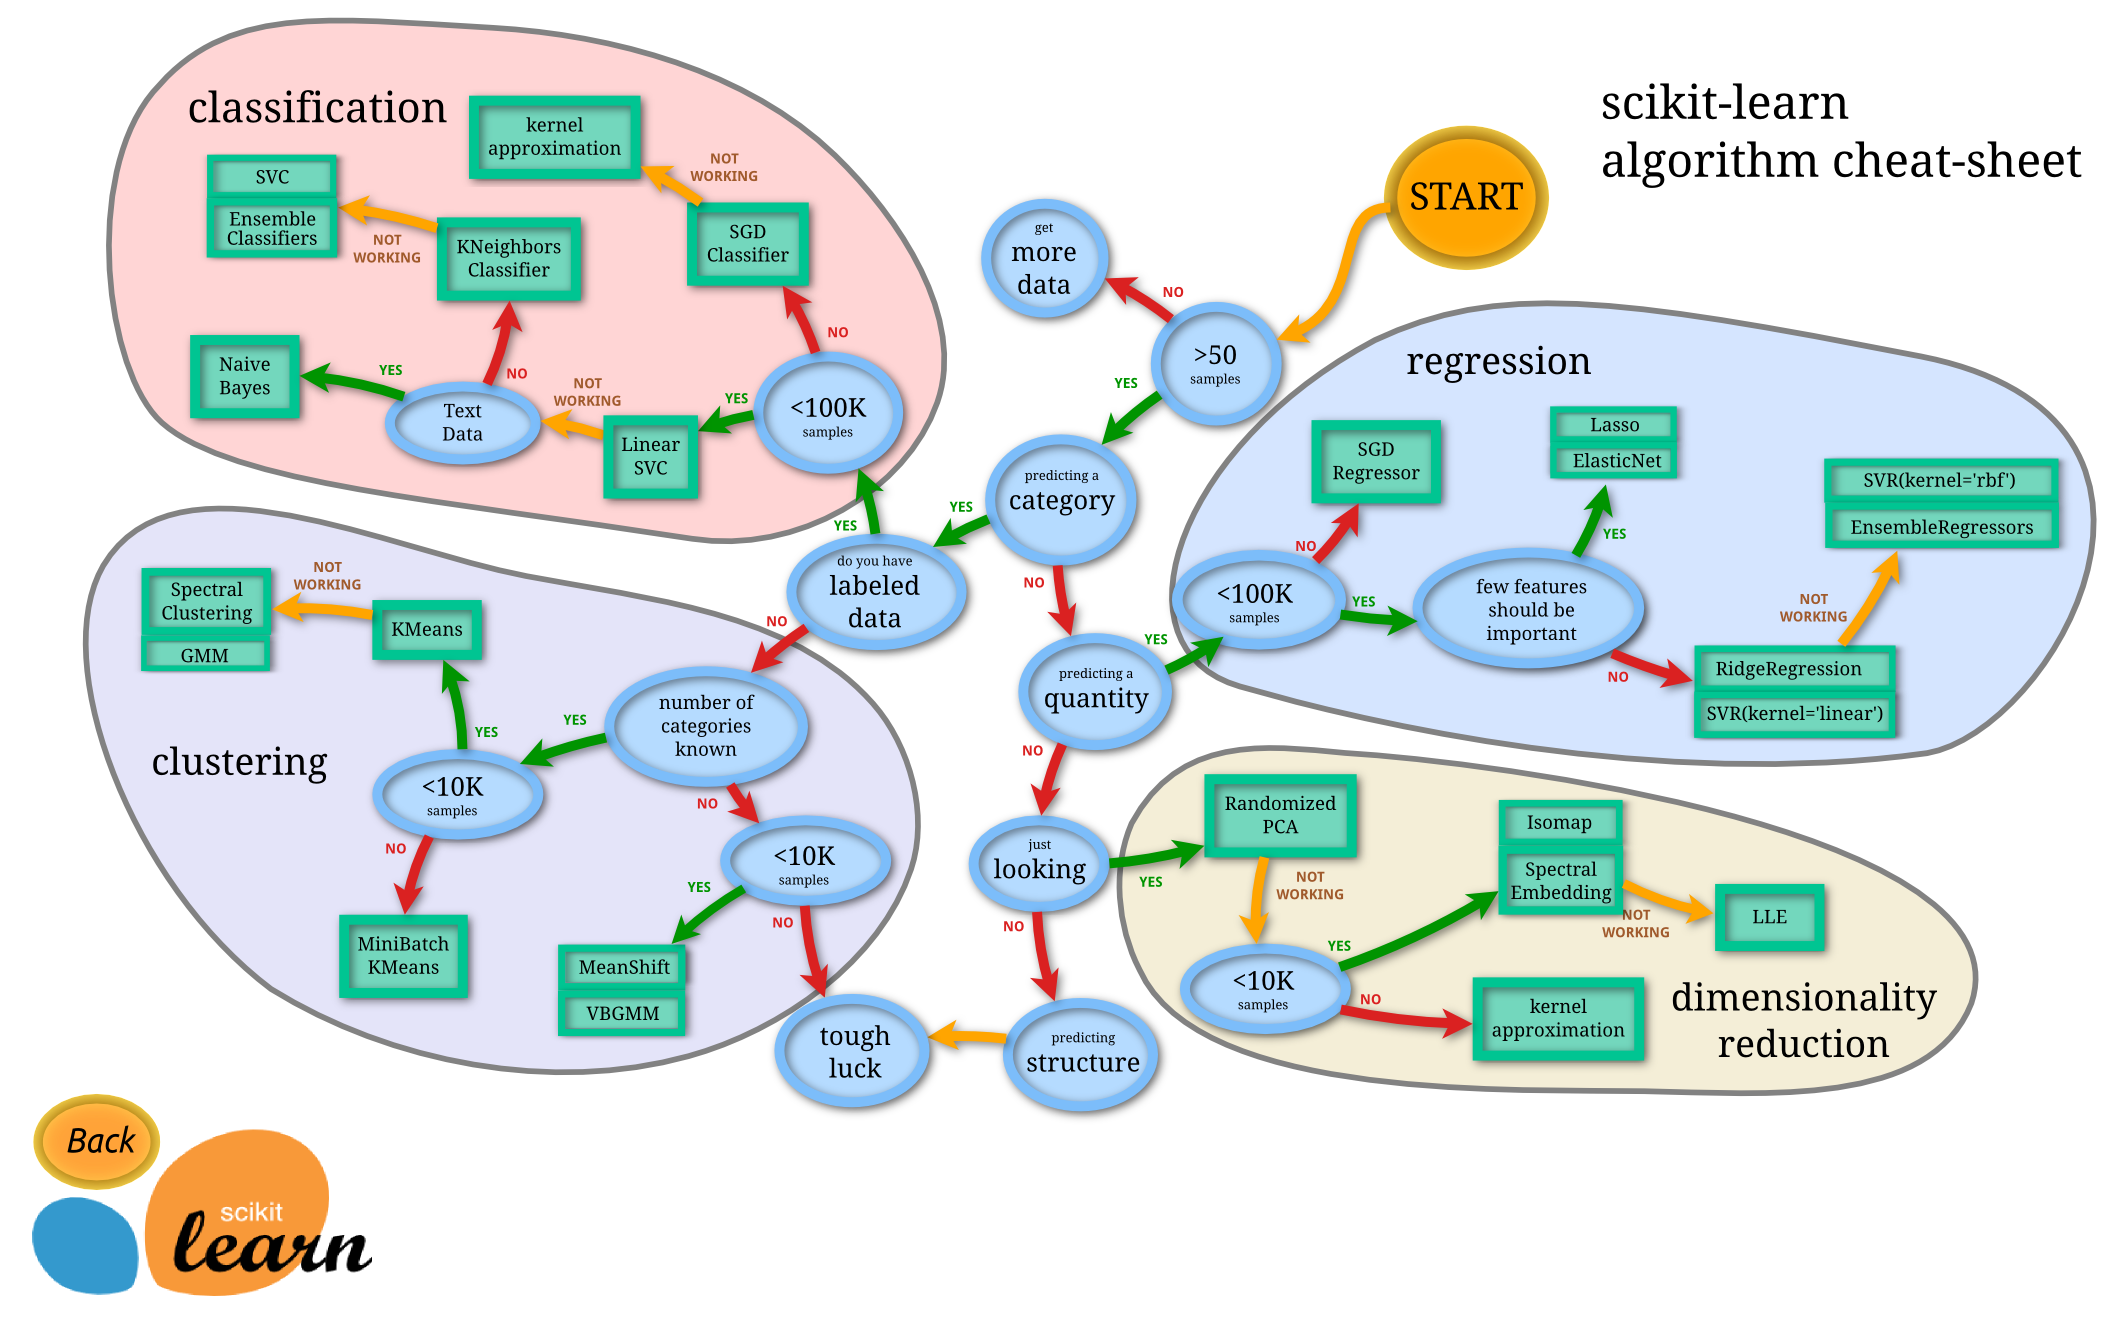
如上图所示,scikit-learn包主要包括四个类别:分类,回归,聚类,降维,将在后续章节一一介绍。

机器学习是人工智能的一个分支,它是一门研究机器获取新知识和新技能,并识别现有知识的学问。机器学习的精确定义为:
It’s a computer program learning from experience E with respect to some task T and some performance measure P, if its performance on T as measured by P, improves with E : Tom Mitchell 1998
机器学习已广泛应用于数据挖掘、计算机视觉、自然语言处理、生物特征识别、搜索引擎、医学诊断、检测信用卡欺诈、证券市场分析、DNA序列测序、语音和手写识别、战略游戏和机器人等领域。
- 监督学习:输入数据带有标签。监督学习建立一个学习过程,将预测结果与 “训练数据”(即输入数据)的实际结果进行比较,不断的调整预测模型,直到模型的预测结果达到一个预期的准确率,比如分类和回归问题等。常用算法包括决策树、贝叶斯分类、最小二乘回归、逻辑回归、支持向量机、神经网络等。
- 非监督学习:输入数据没有标签,而是通过算法来推断数据的内在联系,比如聚类和关联规则学习等。常用算法包括独立成分分析、K-Means 和 Apriori 算法等。
- 半监督学习:输入数据部分标签,是监督学习的延伸,常用于分类和回归。常用算法包括图论推理算法、拉普拉斯支持向量机等。
- 强化学习:输入数据作为对模型的反馈,强调如何基于环境而行动,以取得最大化的预期利益。与监督式学习之间的区别在于,它并不需要出现正确的输入 / 输出对,也不需要精确校正次优化的行为。强化学习更加专注于在线规划,需要在探索(在未知的领域)和遵从(现有知识)之间找到平衡。
- 特征工程
- pass
- 模型评估
- 经典算法