
给一个域名,输出一份 HTML 报告:AI 抓你的站时,哪些位置读到的是错的。
不是 SEO 打分,不是「AI 友好度 87 分」。
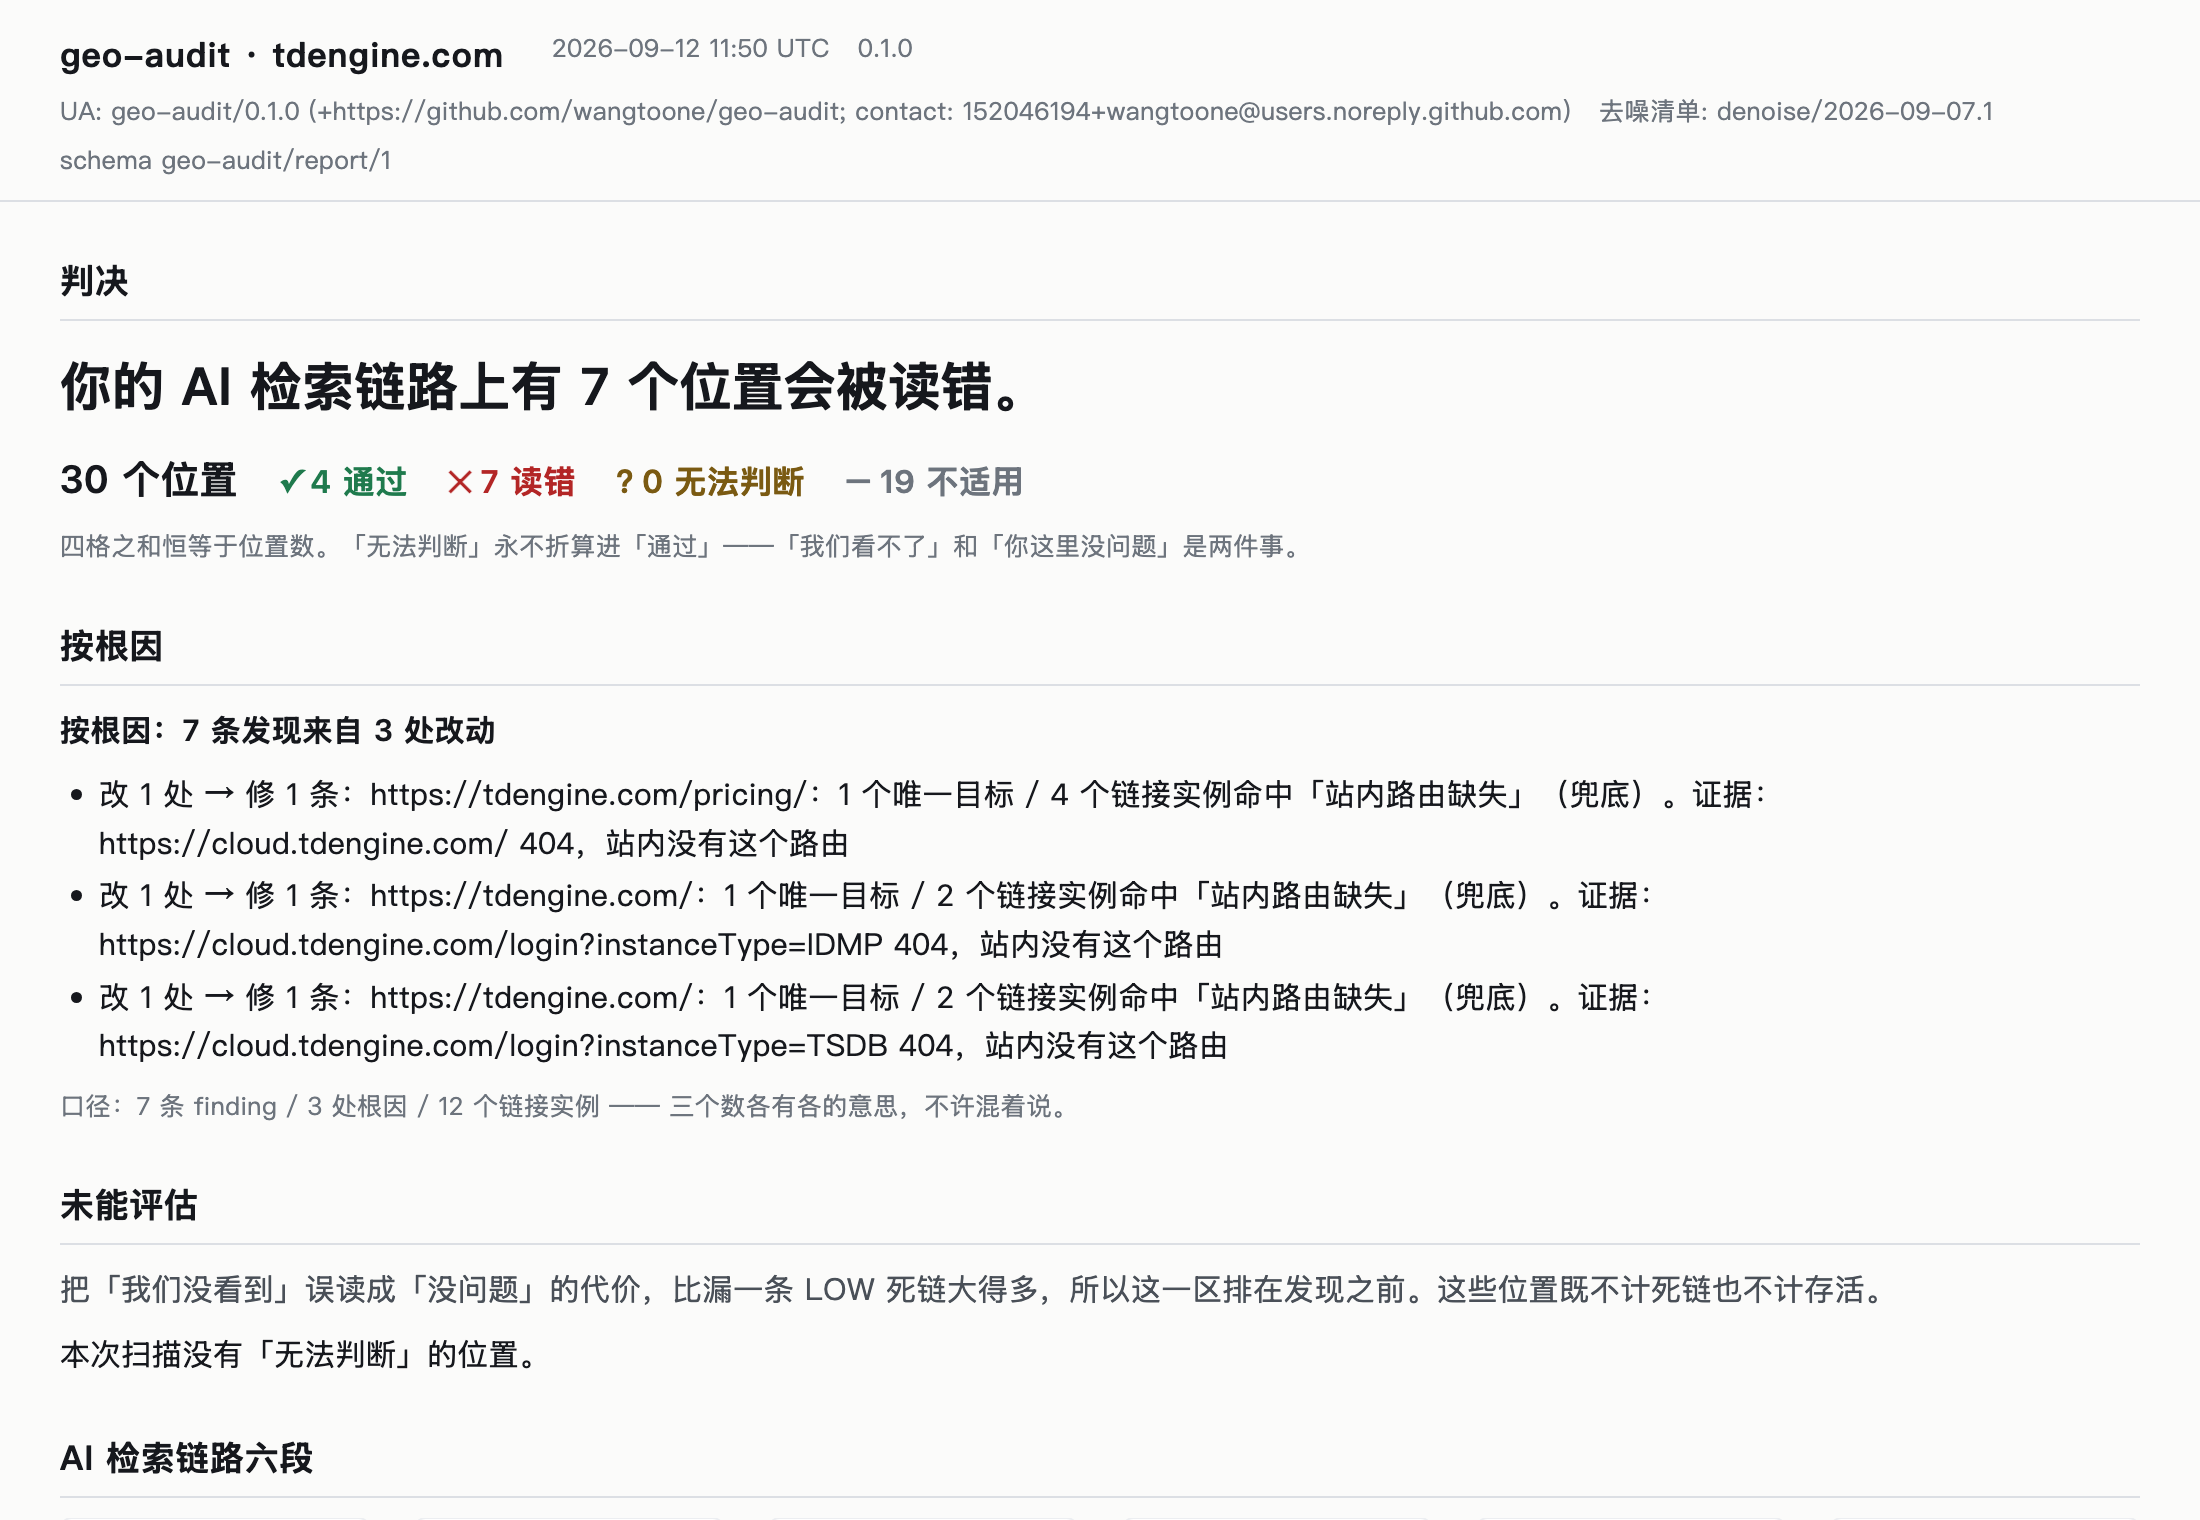
tdengine.com 那份的首屏 · 2026-09-12 活网跑 · 数字会随重跑变化,这张是当时的快照 · 另外八份
两个实测数字说明它跟同类工具的差别在哪。
Give it a domain, get one self-contained HTML report: which places on your
site an AI crawler reads wrong, or cannot read at all. Not an "AI-friendliness
score" — every finding names a position, a root cause, and ships a curl command
that reproduces it.
uvx geo-audit yourdomain.com --contact you@yourco.com
- Zero LLM in the judgment path.
llm_callsis always 0 and a CI gate greps for it. Same input, same verdict. LLMs are allowed to ask questions and draft suggestions — never to decide whether something is a defect. - Every verdict comes with a control probe. We request an invented path
(
/geo-audit-probe-<hex>.txt) on the same host and compare. A response that looks like the invented one is your page shell, not your index file. - Measured, not claimed: on the same 42 dead-link candidates, judging by
first-hop status code gives 40.5% false positives; this tool gives
3.85%, with zero misses.
scripts/fp_gate.pyrecomputes it on every CI run. - "Cannot tell" is its own state, never folded into "pass." Three of the nine published reports open with "this scan is not trustworthy" — because they are.
- Politeness is not optional: 1 request / 2s per domain (
--rateonly slows it down),robots.txtrespected, contact e-mail required in the User-Agent, no WAF bypassing, no CAPTCHA solving, no residential proxies.
Nine real scans of real sites: https://wangtoone.github.io/geo-audit/. Docs, report copy and code comments are in Chinese; the CLI and report are too.
同一批 42 个候选链接,scripts/fp_gate.py 每次 CI 都重算:
| 判死 | 假阳性 | 漏报 | |
|---|---|---|---|
| 只看首跳状态码(≥400 即判死) | 42 条 | 17 条(40.5%) | — |
| 本工具 | 26 条 | 1 条(3.85%) | 0 条 |
差在这五类,每一类都是实测踩出来的:URL 模板占位符({permalink} / ${...})、
地理限制的 404、机器人挑战被误读成 429/403、UA 反爬、只跟第一跳跳转。
那 1 条假阳性(H41)是站方后来把现象修掉造成的漂移,按 §8.1 的规程不改断言、 只留痕,所以门禁口径下是 0 —— 但当前实测就是 1 条,这里不写 0。
gusto.com 那份报告第一行是:
这次扫描不可信:18 个核心位置里有 17 个我们没能评估。下面的结论不要当结论用。
Cloudflare 挡掉了几乎所有位置 —— 而它的 llms.txt 其实是真文件。核心位置里超过
一半无法判断时,报告就这么写,CLI 退出码是 2。
把「我们没看到」写成「你没问题」是这类工具最常见的骗法。
Status.UNKNOWN 在这份代码里永不折算成通过,四格计数之和恒等于位置数,有闸门守着。
(原话,不是示意文案。来自 2026-09-12 那次取消预算上限的 mistral.ai 实跑 —— 画廊里那份跑默认参数,这 75 条在默认 120 请求上限下验不完,报告如实写 「待验证 · 超出本次预算上限」。):
HIGH · AI 通道内部 · ④ 索引内链存活
llms.txt里列的https://docs.mistral.ai/docs/deployment/cloud/sfcortex.md是死链。 该索引 75 条死 / 0 条活 / 0 条判不了。 只探根路径、不做对照探测的实现会说:未采纳(没探这个位置)。 实际是:索引里列的这条链接死了(75/75 条判死)。 改成https://docs.mistral.ai/deployment/cloud/sfcortex← 我们请求过,200。 复现:curl -sSL -A 'geo-audit/0.1.0 (…)' 'https://docs.mistral.ai/docs/deployment/cloud/sfcortex.md'改 1 处 → 修 75 条(75 个链接实例):补页面或改指到现存页。
九份真实站点的真实扫描结果,2026-09-12 活网跑的(不是离线回放)。
索引页:https://wangtoone.github.io/geo-audit/ —— 下面表格里每个域名也都直接点得开。
(clone 之后想离线看,同一批文件在仓库的 docs/ 下。)
| 报告 | 位置 | 通过 | 读错 | 未能评估 | 首屏那句话 |
|---|---|---|---|---|---|
| tdengine.com | 30 | 4 | 7 | 0 | 7 个位置会被读错 |
| gusto.com | 28 | 2 | 4 | 21 | 这次扫描不可信 |
| deepgram.com | 21 | 5 | 2 | 5 | 2 个位置会被读错 |
| minimax.io | 26 | 10 | 2 | 7 | 2 个位置会被读错 |
| saleor.io | 21 | 12 | 1 | 1 | 1 个位置会被读错 |
| modal.com | 29 | 12 | 1 | 6 | 1 个位置会被读错 |
| mistral.ai | 41 | 10 | 1 | 18 | 这次扫描不可信 |
| openstatus.dev | 54 | 6 | 1 | 24 | 这次扫描不可信 |
| rustdesk.com | 15 | 10 | 0 | 0 | 零发现:10 个位置全部通过 |
三份首屏写着「这次扫描不可信」,原因逐条可查,不是报告写坏了:
- gusto.com —— Cloudflare 挡掉 17 个位置(12 条挑战页 + 5 条拦截状态码)。
而它的
llms.txt其实是真文件。 - mistral.ai —— 9 个位置
robots.txt禁止抓,其余撞上默认 120 请求上限:docs.mistral.ai/llms.txt那 75 条内链在默认预算下验不完,报告如实写 「75 条内链待验证 · 超出本次预算上限」,而不是拿一个没验的数充数。 取消上限重跑就能看到那 75 条(下一段有命令和结果)。 - openstatus.dev —— 10 个位置 robots 禁止、6 个撞预算,另外 8 个位置 「答案取决于请求头」(见下面「两把尺子」)。
核心位置里超过一半无法判断时,报告就这么写,CLI 退出码是 2。 把「我们没看到」写成「你没问题」是这类工具最常见的骗法。
geo-audit mistral.ai --fix-candidates --max-requests 0 --index-links-full
完成 · 40 个位置:3 读错 / 9 无法判断 / 14 通过 / 14 不适用
      请求 532 / 上限 不限 · 用时 1949s
④ 索引内链存活  FAIL 77 死 / 64 活   (docs.mistral.ai 那份:75 条内链 0 活 / 75 死)
⑦ 修复目标      精确 39 / 降级 0 / 查过没有 36 / 没能查 2
39 条死链带着验证过 200 的替代地址(.../docs/agents/mcp.md → .../agents/mcp
这一类),36 条是逐个试过确实没有,2 条如实记「没能查」。
画廊里那份不开这个开关,因为画廊一律跑默认参数 —— 装完就是那套,数字才有可比性。
uvx geo-audit yourdomain.com --contact you@yourco.com
Python 3.11+。pipx run geo-audit … 和 pip install geo-audit 一样。
报告是单个 HTML 文件,零外部请求、零 JS,可离线转发、可直接打印、可贴进工单。
真实运行长这样(--replay-fixtures 是用仓库内冻结快照跑,零网络):
$ geo-audit mistral.ai --contact you@yourco.com

geo-audit 0.1.0 · mistral.ai
UA: geo-audit/0.1.0 (contact: you@yourco.com) · 0.5 req/s
robots.txt  遵守(被 Disallow 的位置标「无法评估 · robots 禁止」)
[1/6] ① 入口发现      探 5 个位置 … 3 处有文件
[2/6] ② 索引文件真伪    2 个位置
[3/6] ③ 全文通道      3 个位置
[4/6] ④ 索引内链存活    FAIL 75 死 / 25 活
[5/6] ⑤ .md 通道      有声明但判据不足,按设计不报
[6/6] ⑥ 可点击路径     抽取 0
完成 · 18 个位置:1 读错 / 5 无法判断 / 9 通过 / 3 不适用 · 用时 287s
不会用命令行? Fork 本仓库 / 点 "Use this template" → Actions →
audit-my-domain → Run workflow → 填域名和邮箱 → 两分钟后在同一页面下载 HTML。
不用装任何东西。(那个 workflow 刻意不自动发到 Pages:把别人家域名的体检结果
推成公开页面,是我们没有权利做的事。artifact 保留 30 天,谁跑谁看。)
不走整站体检,只看你点名的东西;不改报告格式,输出自成一份小 JSON(--json)。
# 一个页面的原始 HTML(不跑 JS,多数 AI 爬虫看到的那份)+ 对账你的期望
uvx geo-audit page https://yourdomain.com/pricing --contact you@yourco.com \
    --h1-contains "Pricing" --schema Product --price 20 --no-js-shell

# robots.txt 对各家 AI 爬虫(训练 / 检索 / 实时抓取)分别怎么说,哪一组规则决定了它
uvx geo-audit robots yourdomain.com --contact you@yourco.com
两条都沿用同一套抓取约束(≤0.5 req/s、遵守 robots、带联系邮箱的诚实 UA、不冒充任何爬虫),
没抓到 / 被拦 / 没读到就是「无法判断」,不是通过也不是失败(退出码 3)。
robots 报的是事实:「拦训练、放检索」是正当策略,不算缺陷。它还做几件事:
- 读不到 ≠ 站点没有 ≠ 站点禁止。 5xx、网络错误、防火墙挑战页(AWS 的 Challenge 是 202 + 响应头,
Cloudflare 的是 403 +
cf-mitigated)、限流、跳转超限都记「没读到」;401 / 403 这类说不清是 「没有」还是「被拦」的 4xx,RFC 9309 视为放行,但也不写成「站点没有」。只有观察到的 404 / 410 才是干净的缺席。/robots.txt的跳转会跟(至少 5 跳),读上限 512 KiB(RFC 要求至少 500 KiB)。 - 厂商列。 每个爬虫都带着它的官方文档怎么说它遵不遵守 robots.txt:用户点名的实时抓取
(ChatGPT-User、Perplexity-User、meta-externalfetcher、Amzn-User)文档写明可能不遵守,
所以被禁止了也可能照样来,文字输出里标 ⚠;文档没明说的(目前是 PerplexityBot)标
「厂商文档未明说是否遵守」,不替厂商补一句。Google-Extended / Applebot-Extended 是控制标记,
不是爬虫;Applebot 没被点名时按 Googlebot 的组走(Apple 文档),Bingbot 按 bingbot → msnbot →
*的顺序只认一组(Bing 官方博客)。Amazon 的文档对 Amzn-SearchBot 另有说明(没点名它、但放行了别的 搜索爬虫时,它按那些爬虫的规则走),这种情况下它那一行会带 ⓘ 提醒,而不是直接报「全站禁止」。 JSON 里每个爬虫都有honors_robots(yes / no_by_design / unstated)和doc(我们读过的页面, 写的是页面自己声明的规范地址)。 - 用法错(拼错的参数、
--timeout不是大于 0 的数)退出码 4,与整站体检一致。
报告里 llm_calls 恒等于 0,且有 CI 门禁 grep 着判定层不许出现任何 LLM 调用。
判定函数不接 LLM client —— 同一输入必得同一输出。
① AI 路径体检 —— 你的 llms.txt / llms-full.txt / .md 通道是真的能用,
还是只是看起来存在。每一条判定都跟一个对照探测:我们同时请求一个随机编造的
路径(/geo-audit-probe-<随机十六进制>.txt),两边一比才下结论。
拿回来的东西和编造路径拿回来的是同一份骨架 → 那不是你的索引,是你的页面外壳。
两把尺子:文本位置还会用 Accept: */* 再量一次。原因是我们量出来的 ——
100 个真实 AI 路径位置里,9 个的答案取决于请求头:
openstatus.dev / dev.wix.com 的 llms.txt
  带 text/markdown -> 404 几百字节      */* -> 200 真文件
ecwid / attio / pipedrive / printify / moderntreasury 的 llms.txt
  带 text/markdown -> markdown 正文     */* -> HTML 页面壳
第二类更要命:只用一把尺子的话,工具拿到 markdown 就判「通过」,而发 */* 的
抓取器拿到的是页面壳 —— 正是这个工具专门在找的那种缺陷,被请求头挡住了。
两把尺子不一致时这个位置判「无法判断 · 答案取决于请求头」,两边读数各带
curl 复现命令写进报告。我们不替你决定哪一把才算数:那要先有「AI 抓取器实际
发什么 Accept」的分布数据,而我们没量过。
② 死链 —— 只报「人和 AI 都会点、点了就 404」的链接,按根因归并、按位置 分级。销售路径上的一条和页脚社交图标上的一条,我们不当成同一件事。
锚点腐烂、sitemap、图片/CSS 资源、事实是否自相冲突、内容是否过期。
(robots 对 AI 爬虫的放行不在整站体检里查,单点命令 geo-audit robots 才查。)
最后两项不是没想到,是试过之后砍掉的,理由是我们自己的实测数字:
- 内容过期:通用「旧年份」正则在两批独立样本上扫出 134 条命中 0 条真信号、 296 条命中 2 条真信号;人工复核那 21 条过期信号时,推翻 1 条、降级 3 条、 重复计 3 条。做进产品就是骚扰。
- 事实冲突:自动化版本从来没跑过,所以这一整块的假阳性率是空的 —— 我们不 知道它会错到什么程度,那就不能发。(而且「属性对」这个计数单位实测伸缩 15 倍: 同一张套餐表,一个域记成 1 对,另一个记成 17 对。)
把没验证过的检查装进产品,是这类工具第二常见的骗法。
因为大多数域名报不出多少条。我们在 72 个域名上实测过: 20.8% 一条都报不出来,52.8% 只有 1–2 条,只有 26.4% 能报 3 条以上。
一份只有 2 条的报告卖不出去,但那 2 条所在的位置和根因是真值钱的: 11,608 条链接查出 94 条死链,其中 66 条挤在 7 个域名上; mistral.ai 那份里 76 条 finding 收敛成 1 处根因——「改 1 处 → 修 75 条」。
所以第一页是你的 AI 检索链路图、六段里每一段的通过/失败/无法判断,以及一张
对照表:只探根路径、不做对照探测的实现,会在你的哪几个位置上读错。
(这句话说的是一种实现方式在你这几个具体位置上的行为,每条都附 curl 命令
自己复现。我们没有拿任何别的产品跑过对照,所以不会替它们说话。)
会落到这一态的:WAF 挡了、限流了、正文是 JS 渲染的、robots 不让抓、撞上请求 预算上限。报告里那一整区(「未能评估」)排在发现之前,每条都写清原因码和 怎么重跑 —— 排在后面就等于默认没人看。
(为什么这件事是重点,见开头第二节。)
- 单域名每 2 秒 1 个请求(
--rate只能调慢,调快直接报错退出); - User-Agent 里必须带你的联系邮箱(
--contact缺失直接退出 4,--replay-fixtures和--from也不豁免); - 默认遵守
robots.txt;被 Disallow 的位置标「无法判断 · robots 禁止」, 不会标成「通过」;robots.txt自己读不到(5xx / 网络错误 / 跳转成环)时保守地不抓这个 host (RFC 9309 对 5xx 与网络错误就是这么要求的),位置标「无法判断 · robots.txt 读不到」—— 不是「你的 robots.txt 禁止」;防火墙挑战页、限流、401 / 403 按 RFC 是「不可用」,照常抓, 每个位置会各自带上具体的挑战证据; - 只抓无需登录的公开页;不绕 WAF、不解 CAPTCHA、不用住宅代理。 遇到挑战页就标「无法判断」然后走开;
- 请求上限默认不设;在交互终端里开跑前会问你想花多久,按每 2 秒 1 个请求换算成上限
(约 1000 个请求 ≈ 33 分钟)。脚本 / CI 里用
--max-requests N显式限制。超限的位置标 「无法判断 · 超出预算」,而不是悄悄跳过。
没有托管 web 版,这不是偏好问题。 托管版意味着我们代替你去抓第三方域名,
UA 里的联系邮箱就变成我们的而不是发起人的(--contact 这条约束当场失效),
而且一个「输入任意域名就发请求」的公开端点就是开放抓取代理,会被用来打人。
CLI 和 GitHub Action 的形态里,请求永远从你自己的出口发出、UA 里是你自己的邮箱。
见 CONTRIBUTING.md。MIT,见 LICENSE 与 NOTICE。